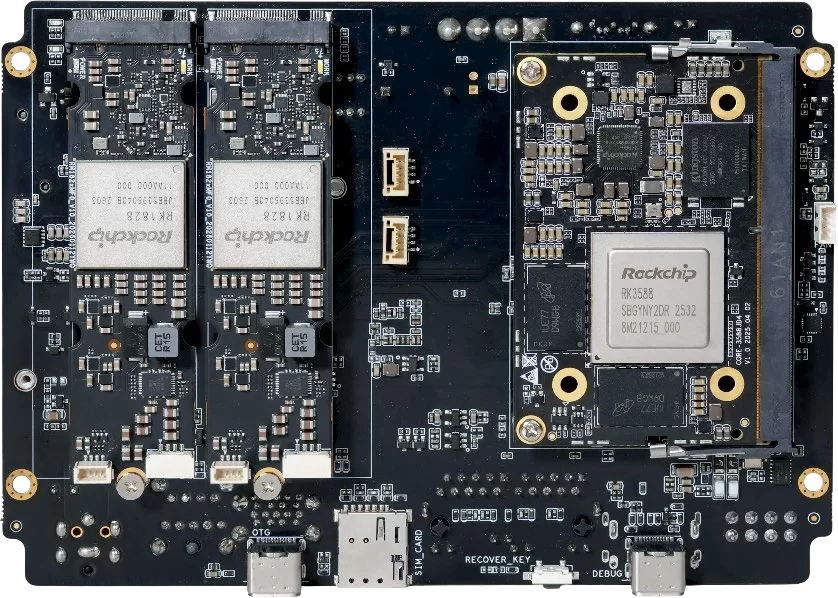
2026 年 8 月 14 日晚,阿里巴巴通义实验室正式开源 Qwen3.8-27B;8 月 15 日,后摩智能宣布其 M50 芯片(对应爱派派 AIBOX PRO KIT 的「双 LQ50」算力模组)同步完成该模型的深度适配,并将 27B 级别模型的端侧部署时效性首次推到 Day 0(权重发布当天即端到端跑通)。搭载双 LQ50 模组的爱派派 AIBOX PRO KIT 整机,借此成为一台「移动电源即可供电、本地跑通千问目前最强开源 27B 模型」的工业级边缘推理设备。
本文关键词:后摩智能 M50、LQ50、爱派派 AIBOX PRO KIT、RK3588、Qwen3.8-27B、Day 0 适配、端侧大模型、27B 推理、边缘 AI、后摩大道工具链、262K 上下文、4-bit 量化
---
8 月 14 日晚,阿里通义实验室正式开源 Qwen3.8-27B。作为千问团队的紧密合作伙伴,后摩智能同步完成 Qwen3.8-27B 在其 M50 芯片上的深度适配,并把 27B 级模型的端侧部署时效性首次推到 Day 0。
开发者通过后摩大道工具链,即可在 M50(单 M50 或双 M50)上完成「从量化编译到推理部署」的全流程,将 Qwen3.8-27B 运行于端侧设备。搭载 M50 芯片的量产终端设备(含爱派派 AIBOX PRO KIT 双 LQ50 配置)已同步支持 Qwen3.8-27B 本地推理。
| 时间节点 | 事件 |
|---|---|
| 2026-08-14 晚 | 阿里通义实验室正式开源 Qwen3.8-27B(Apache-2.0) |
| 2026-08-15 | 后摩智能宣布 M50 完成 Qwen3.8-27B 深度适配,端侧部署推到 Day 0 |
| 同步 | 搭载 M50 的量产终端(含 AIBOX PRO KIT 双 LQ50)支持本地推理 |
---
| 项目 | 参数 / 事实 |
|---|---|
| 模型类型 | 原生多模态稠密(Dense)模型 |
| 参数量 | 27B(270 亿) |
| 原生上下文 | 262K Tokens |
| 上下文外推 | 通过 YaRN 技术可外推至 1M Tokens |
| 4-bit 量化体积 | 约 17 GB |
| 相对 Qwen3.6-27B | 编程、办公场景性能大幅提升 |
| 对比 Qwen3.7-Plus | 表现超越 Qwen3.7-Plus |
| 新增能力 | reasoning_effort:按任务难度控制思考深度,更省资源 |
| 端到端能力 | Qwen3.8 系列共性:可端到端完成复杂任务,直接交付经得起检验的可靠成果 |
---
后摩大道工具链的适配策略是以模型架构为单位,而非以单个模型为单位。同一架构的模型共享相同的 ONNX 导出图,量化编译流程可直接复用。
Qwen3.8-27B 与后摩智能已支持的 Qwen3.6 系列共享底层架构,这是此次 Day 0 适配的技术基础。工具链内部已完成对该架构的算子映射和推理引擎对接,模型权重发布后无需重新做底层适配,直接进入量化编译阶段。
| 维度 | 后摩大道工具链支持情况 |
|---|---|
| 适配策略 | 以模型架构为单位,同一架构共享 ONNX 导出图,量化编译流程可复用 |
| 框架 | 内置 Qwen 系列完整算子优化,支持 PyTorch、vLLM 等主流框架 |
| 推理引擎 | 编译产物可通过 llama.cpp、vLLM、SGLang 部署为标准化 API 服务 |
| Agent 框架 | 与 OpenClaw 等 Agent 框架无缝对接 |
| 终端 | 搭载 M50 的量产设备(单 / 双 M50)同步支持 Qwen3.8-27B 本地推理 |
---
端侧 AI 长期面临一个根本矛盾:大模型参数持续增长,终端设备的物理约束却几乎不变。Qwen3.8-27B 的 4-bit 量化版约占 17GB,M50 单芯片功耗仅 10~15W,双芯片功耗不到 30W。这意味着,一个移动电源即可供电的端侧设备,可在本地跑通千问目前最强的开源 27B 模型。
更重要的在于响应速度:模型权重发布当天即完成适配,开发者不需要等芯片厂商的适配周期。
| 项目 | 数值 |
|---|---|
| Qwen3.8-27B(4-bit)体积 | 约 17 GB |
| M50 单芯片功耗 | 10 ~ 15 W |
| M50 双芯片功耗 | < 30 W |
| 供电 | 移动电源即可驱动 |
| 落地形态 | 端侧设备本地跑通千问最强开源 27B 模型 |
---
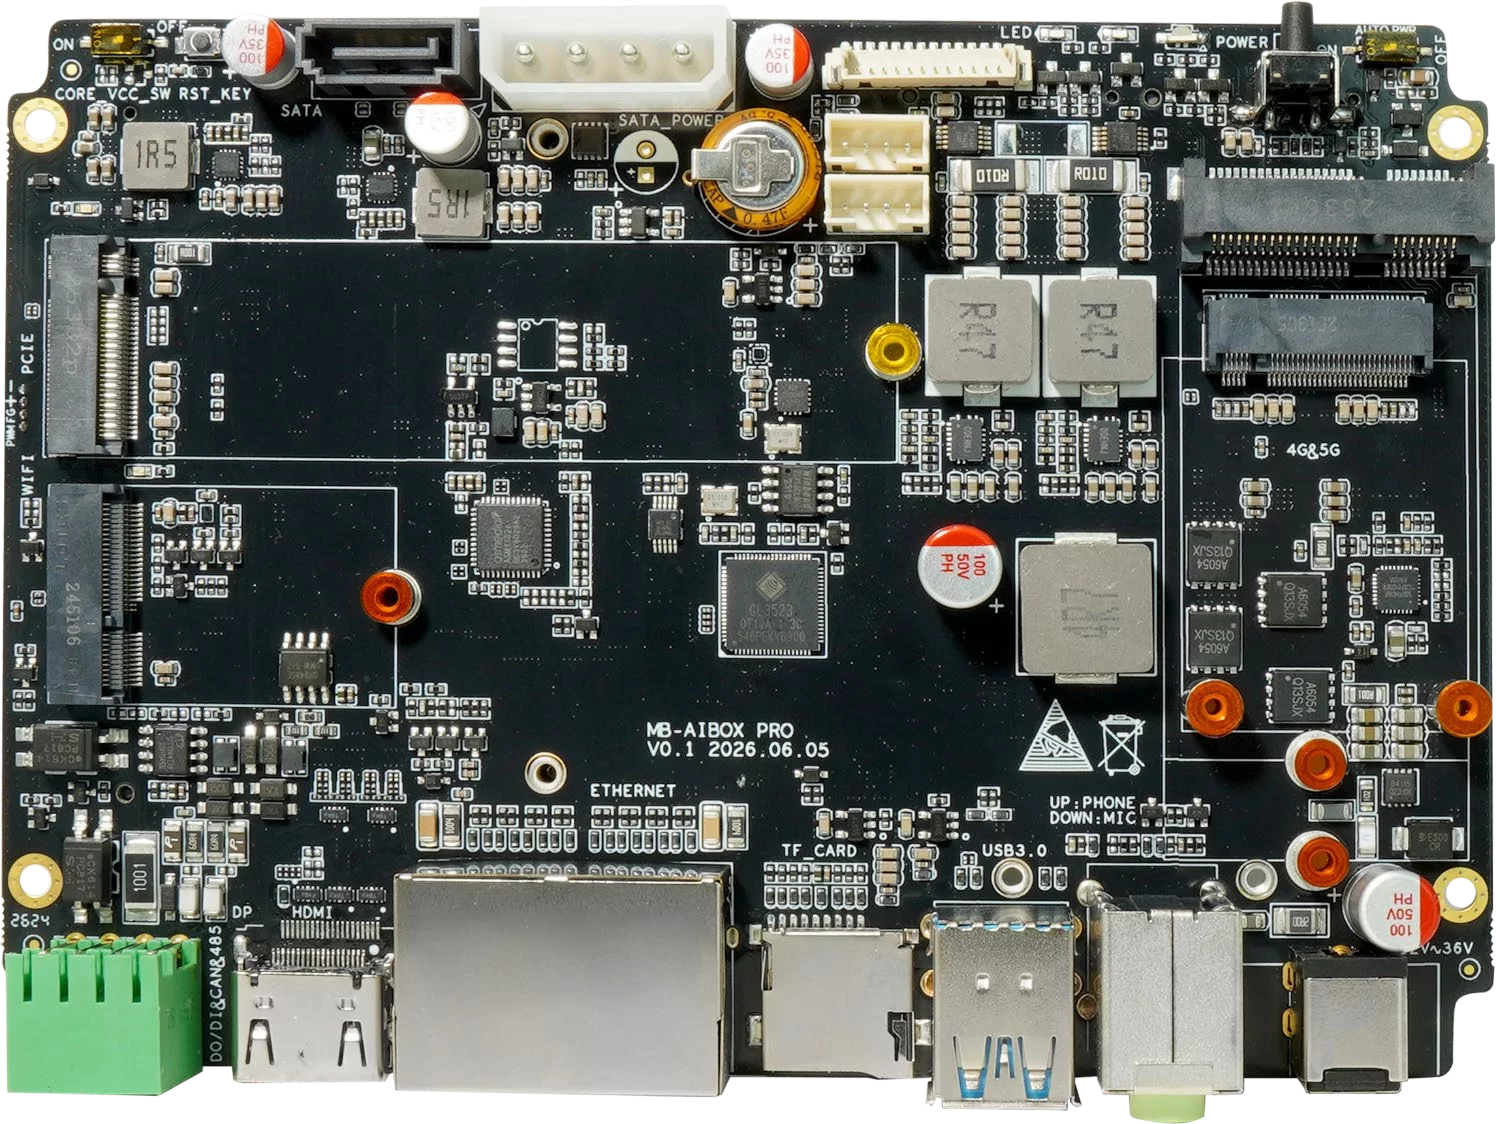
LQ50 是后摩 M50 的 M.2 形态算力卡(口香糖尺寸,Duo M.2 双卡形态)。爱派派 AIBOX PRO KIT 预留双路 M.2 Key M 扩展位,选配双 LQ50 模组后,即成为一台工业级的 27B 端侧推理整机——RK3588 负责系统调度与视频编解码,双 LQ50 专注大模型推理,通过 PCIe 高速互联。
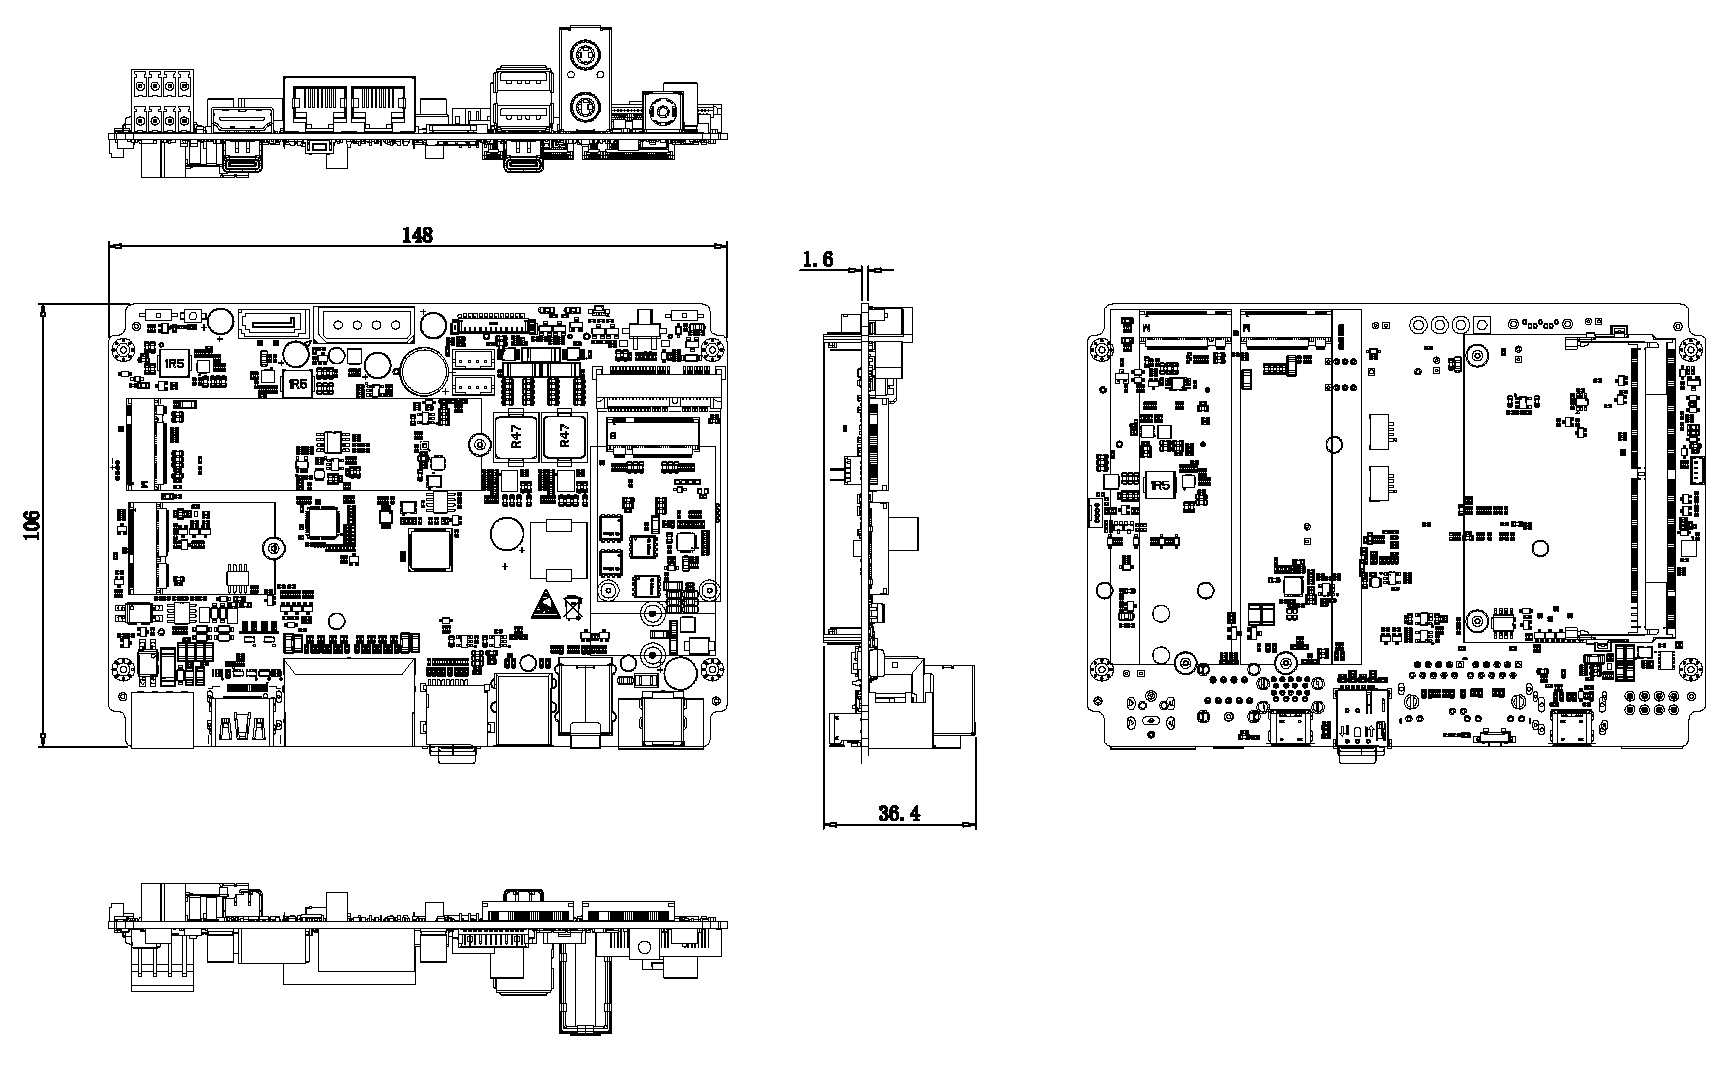
| 模块 | 配置 |
|---|---|
| 主控模组 | RK3588(Core-3588JD4)+ 6 TOPS NPU + 8K VPU |
| AI 算力扩展 | 2 × M.2 Key M(PCIe)× LQ50(后摩 M50) |
| 互联 | PCIe(主控调用 LQ50,模型分片低延迟传输) |
| 整机尺寸 | 148.0 × 106.0 × 36.4 mm |
| 工作温度 | -20 ℃ ~ 60 ℃ |
| 输入电压 | DC 12 V 宽压(9 V ~ 36 V) |
| 接口 | 双千兆、USB3.0×2、USB2.0×2、HDMI 2.1(4K@60Hz)、M.2 E/B/M、Mini PCIe、RS485、CAN-FD、光耦隔离 DI/DO、SATA3.0、SIM、TF、Type-C |
---
后摩大道工具链覆盖「从模型量化到编译再到推理服务」的全链路。以下是 Qwen3.8-27B 在 M50 上的完整部署流程(单 / 双 M50 均可,--ndevice 控制)。
| 步骤 | 动作 | 关键命令 / 参数 |
|---|---|---|
| 1. 资源下载 | 从后摩开发者社区下载工具链资源包;从 Hugging Face / ModelScope 获取 Qwen3.8-27B 权重 | — |
| 2. 量化导出 | GPTQ 后训练量化,逐层替代:每次加载一层到 GPU,用校准数据跑前向收集激活值分布,基于 Hessian 矩阵将 FP16 权重压缩为 4-bit,最小化量化误差 | python ptq.py --config config.yaml --model <path>/Qwen3.8-27B/ |
| 3. HMONNX 导出 | 量化后权重加载到 ONNX 计算图;导出后自动跑余弦相似度校验,对比 PyTorch 原始输出与 HMONNX 输出,确保精度无偏差 | 余弦相似度校验 |
| 4. 编译 | 将 HMONNX 图转化为 M50 可执行的 HMM 文件 | python build.py ... --ndevice 1 |
| 5. 推理测试 | 在 M50 设备上运行推理测试 | python demo.py ... --topk 50 --topp 0.9 --repetition_penalty 1.05 |
| 6. llama.cpp 部署 | 编译产物转 GGUF,通过 llama-server 部署为生产推理服务;OpenAI 兼容 API 接入 Agent 框架 | ./bin/llama-server -m ./scripts/qwen3.8-27b.gguf |
python build.py
    --model_dir output/xh2/hmquant
    --model_name qwen3.8-27b
    --ncore 2
    --context_length 32768
    --prefill_length 256
    --stage build
    --j 16
--ndevice 1| 参数 | 说明 |
|---|---|
--ncore 2 |
芯片运行时使用的计算核心数 |
--context_length 32768 |
最大上下文窗口;编译时设 32K 以优化编译速度,M50 实际可支持更大窗口 |
--prefill_length 256 |
prefill 阶段每次分块处理的 token 数 |
--ndevice 1 |
单芯片编译;也可指定 2 做双芯片部署(AIBOX PRO KIT 双 LQ50) |
--stage build |
仅编译;确认通过后可追加 --stage test 跑余弦相似度验证 |
--j 16 |
并行度 |
python demo.py
    --tokenizer_dir <tokenizer path>
    --prefill_path output/xh2/qwen3.8-27b_prefill.hmm
    --decode_path output/xh2/qwen3.8-27b_decode.hmm
    --embedding_path output/xh2/hmquant/quant_embedding.pt
    --ndevice 1
    --topk 50
    --topp 0.9
--repetition_penalty 1.05| 参数 | 说明 |
|---|---|
--topk 50 |
top-k 采样 |
--topp 0.9 |
top-p 采样 |
--repetition_penalty 1.05 |
重复惩罚 |
--ndevice 1 |
单 / 双芯片(双 LQ50 设 2) |
python ./scripts/convert_hm_to_gguf.py /<path to model directory> --use-temp-file
./bin/llama-server -m ./scripts/qwen3.8-27b.gguf
部署完成后即可通过 OpenAI 兼容 API 接入 Agent 框架,实现从模型推理到业务落地的完整闭环。
---
| 场景 | 典型任务 | AIBOX PRO KIT 双 LQ50 的契合点 |
|---|---|---|
| 工业自动化 | 工艺文档问答、设备故障对话式诊断 | 数据不出厂、27B 本地推理、不依赖云端 |
| 智能安防 | 视频事件描述 + 事件语义检索 | 本地多模态推理、低延迟告警 |
| 智能驾驶 / 车载 | 座舱语音助手、车内知识问答 | 宽压 9~36 V 供电、-20~60℃ 工况、双 LQ50 支持 27B |
| 机器人 | 本地任务规划、自然语言指令 | 小体积(148×106×36.4 mm)可内置、低功耗 |
| 智慧商显 / 零售 | 本地客服、商品问答 | 无网 / 弱网仍可工作、保护商业数据 |
| 边缘智能体(Agent) | 工具调用、本地知识问答 | OpenAI 兼容 API 直连 Agent 框架 |
| AI NAS / 家庭服务器 | 本地语义检索、文档问答 | SATA 3.0 + TB 级存储扩展 |
---
Qwen3.8-27B 开源当天,后摩智能 M50(爱派派 AIBOX PRO KIT 的「双 LQ50」算力模组)即完成 Day 0 适配。这意味着:
这不是「端侧要替代云端」的故事——端侧和云端各有各的位置。后摩智能 M50 的 Day 0 适配,给爱派派 AIBOX PRO KIT 双 LQ50 整机提供了一条已经就绪、可以马上跑起来的 27B 端侧推理通路:在数据不外传的前提下,把千问目前最强的开源 27B 模型,落到车间、车里、机房里的边缘设备上。
爱派派 AIBOX PRO KIT(RK3588 + 双 LQ50 模组)现已开放评估套件与样机对接,欢迎联系深圳市爱派派智能科技有限公司获取规格书、报价与 Day 0 部署支持。
---
如需 AIBOX PRO KIT 完整规格书、LQ50(后摩 M50)模组选配清单、Day 0 部署文档,欢迎前往 ai-paipai.com 联系与采购。