{
“@context”: “https://schema.org”,
“@type”: “Article”,
“headline”: “RK3588 + RK1828 边缘 AI 模组实测报告:从 0.5B 到 27B,42 组模型性能数据与选型结论”,
“description”: “基于 RK3588 主控 + RK1820/RK1828 协处理器的实测报告:42 组数据覆盖 LLM、多卡级联、VLM、全模态、图像分类与目标检测,并给出指标定义、读数方法与选型建议。”,
“author”: {“@type”: “Organization”, “name”: “深圳市爱派派智能科技有限公司”},
“publisher”: {“@type”: “Organization”, “name”: “深圳市爱派派智能科技有限公司”, “url”: “https://ai-paipai.com”},
“datePublished”: “2026-10-21”,
“dateModified”: “2026-10-21”,
“mainEntityOfPage”: “https://ai-paipai.com”,
“keywords”: “RK3588, RK1828, RK1820, 边缘AI, 大模型推理, TTFT, TPOT, TPS, Decode TPS, Qwen3, Gemma, YOLO, VLM, 多模态, 多卡级联, PCIe, NPU”,
“about”: [
{“@type”: “Thing”, “name”: “Edge AI”},
{“@type”: “Thing”, “name”: “RK3588”},
{“@type”: “Thing”, “name”: “RK1828 NPU Accelerator”},
{“@type”: “Thing”, “name”: “Large Language Model Inference”},
{“@type”: “Thing”, “name”: “Multimodal Model”}
]
}
RK3588 加一颗 RK1828 协处理器,端侧到底能跑多大的模型、跑多快?这份报告用 42 组实测数据回答这个问题:从 0.5B 的小模型,一直到四卡级联的 27B,覆盖 LLM、多卡级联 LLM、VLM 视觉语言、全模态、图像分类和目标检测六大类任务。
所有数据都在同一套平台上取得:RK3588 主控通过 PCIe 连接 RK1820 / RK1828 协处理器,协处理器 NPU 频率 1GHz,RK3588 设为性能模式。除了完整数据表,更重要的是说明这些数字怎么读、不同列之间能不能横向比、以及按场景该怎么选。
如果只看几个数字,这六条最值得记住:
| 结论 | 实测数字 |
|---|---|
| 小模型(0.5B)单卡解码速度 | 224.19 TPS,TTFT 仅 21.74 ms |
| 主流 7B 模型单卡解码速度 | 70.47 TPS(Qwen2.5-7B / RK1828) |
| 8B 模型单卡解码速度 | 61.92 TPS(Qwen3-8B / RK1828) |
| 27B 大模型(四卡级联) | 13.06~13.08 TPS,TPOT 约 76 ms |
| 浮点/分类模型吞吐 | MobileNetV2 单核 287.78 FPS,多 batch 多核 1361.2 FPS |
| 目标检测吞吐 | YOLOv8s 单核 34.38 FPS,多 batch 多核 221.79 FPS |
单卡 RK1828 足以流畅承载 3B~8B 级别的对话模型(50~100 TPS),而 27B 级别的大模型需要四卡流水线级联,能跑到约 13 TPS——这个速度用于文档处理、批量总结、代码辅助等「不以人眼阅读速度为瓶颈」的场景是够用的。
测试平台由 RK3588 主控与 RK1820 / RK1828 协处理器组成,两者之间通过 PCIe 连接。协处理器负责模型推理,RK3588 负责系统调度、数据搬运与前后处理。
| 项目 | 配置 |
|---|---|
| 主控 | RK3588(测试时设置为性能模式) |
| AI 协处理器 | RK1820 或 RK1828(两者 NPU 频率均为 1GHz) |
| 主控与协处理器互联 | PCIe |
| 多卡级联方式 | RK3588 主控 + 多张 RK1828,采用流水线并行级联 |
| VLM / 全模态 | Vision 编码与 LLM 部分独立测试 |
大模型推理的性能不能只看「吞吐」一个数字,必须区分首字延迟和持续生成速度。本报告使用业界通用的三个指标:
| 指标 | 全称 | 含义 | 用户感受 |
|---|---|---|---|
| TTFT | Time To First Token | 模型生成第一个 token 所需的时间 | 按下回车后要等多久才「开始出字」 |
| TPOT | Time Per Output Token | 生成每个输出 token 所需的平均时间 | 出字的速度,直接决定阅读是否跟得上 |
| TPS | Tokens Per Second | 模型每秒能生成的 token 数量 | 整体吞吐,近似等于 1000 / TPOT |
怎么读这三个数:TTFT 决定「响应感」,TPOT / TPS 决定「流畅感」。举例来说,Qwen2.5-7B 的 TPOT 是 14.19 ms、Decode TPS 为 70.47——约合每秒 70 个 token,远快于人眼阅读速度(中文阅读约每秒 5~8 字),所以单从速度看是「绰绰有余」的;真正需要关注的是 TTFT 在长提示词下会显著上升(见第四节)。
表中有部分行的加速芯片标注为 RK182X,这表示该组数据使用的加速芯片可以是 RK1820 或 RK1828,原始报告未在每一行单独区分。因此:
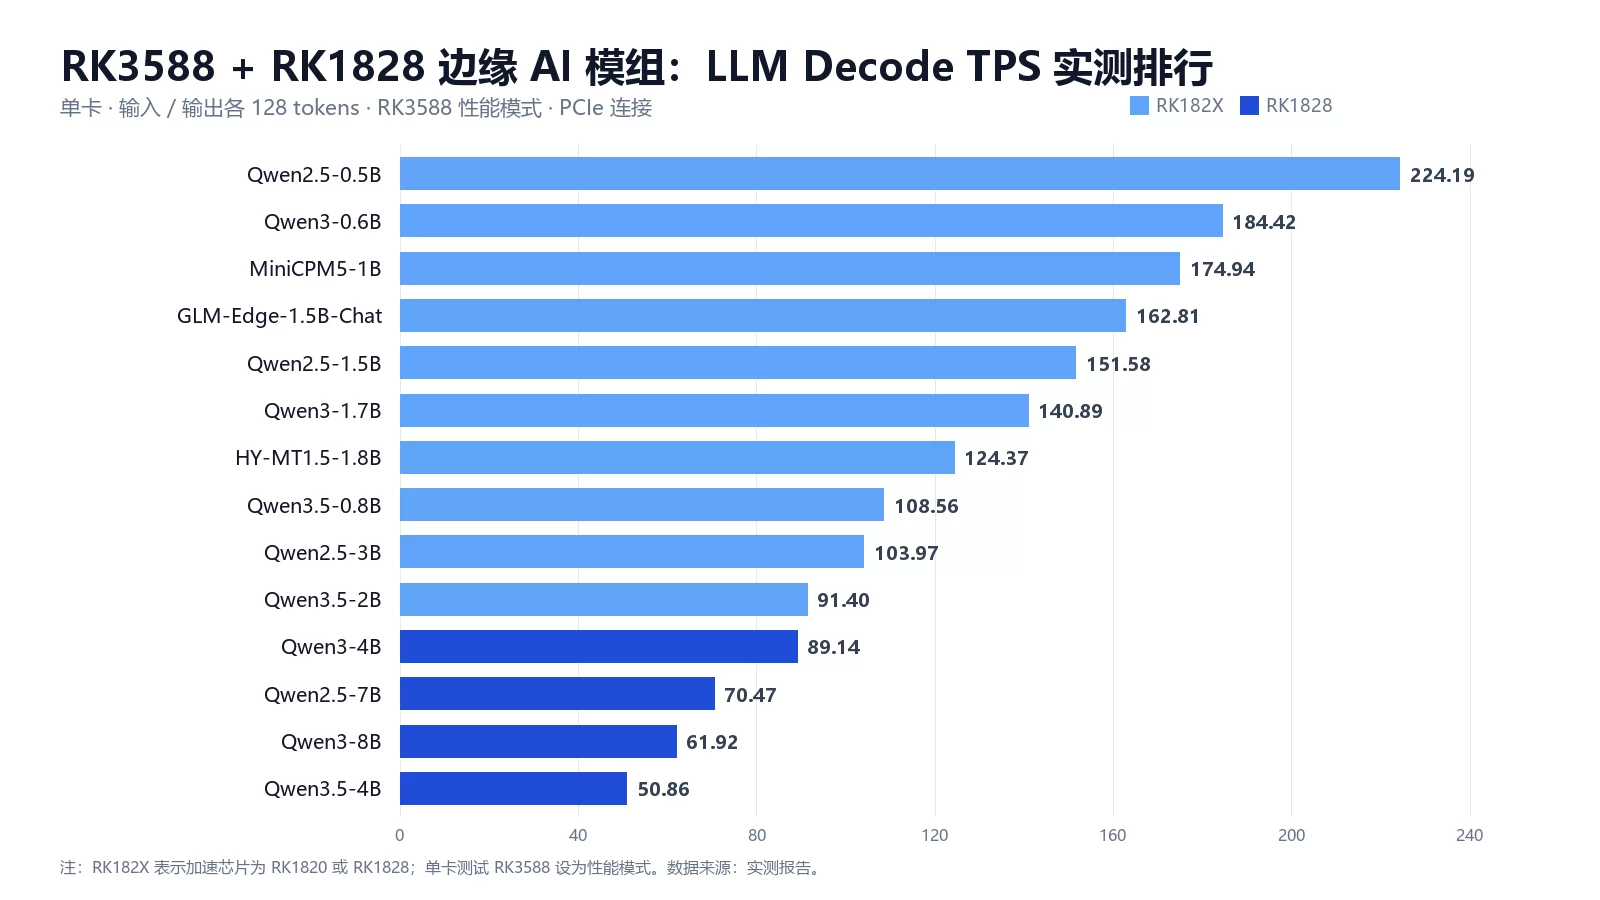
先看最常用的场景:单卡跑纯文本大模型。测试输入 128 tokens、输出 128 tokens,覆盖 Qwen2.5、Qwen3、Qwen3.5、MiniCPM5、HY-MT、GLM-Edge 等主流开源系列,参数量从 0.5B 到 8B。
| 模型名称 | 加速芯片 | Input Tokens | New Tokens | TTFT (ms) | TPOT (ms) | Decode TPS |
|---|---|---|---|---|---|---|
| Qwen2.5-0.5B | RK182X | 128 | 128 | 21.74 | 4.46 | 224.19 |
| Qwen2.5-1.5B | RK182X | 128 | 128 | 47.25 | 6.60 | 151.58 |
| Qwen2.5-3B | RK182X | 128 | 128 | 83.18 | 9.62 | 103.97 |
| Qwen2.5-7B | RK1828 | 128 | 128 | 156.94 | 14.19 | 70.47 |
| Qwen3-0.6B | RK182X | 128 | 128 | 27.74 | 5.42 | 184.42 |
| Qwen3-1.7B | RK182X | 128 | 128 | 52.15 | 7.10 | 140.89 |
| Qwen3-4B | RK1828 | 128 | 128 | 105.64 | 11.22 | 89.14 |
| Qwen3-8B | RK1828 | 128 | 128 | 175.61 | 16.15 | 61.92 |
| Qwen3.5-0.8B | RK182X | 128 | 128 | 56.54 | 9.21 | 108.56 |
| Qwen3.5-2B | RK182X | 128 | 128 | 79.32 | 10.94 | 91.40 |
| Qwen3.5-4B | RK1828 | 128 | 128 | 160.56 | 19.66 | 50.86 |
| MiniCPM5-1B | RK182X | 128 | 128 | 35.69 | 5.72 | 174.94 |
| HY-MT1.5-1.8B | RK182X | 128 | 128 | 58.54 | 8.04 | 124.37 |
| GLM-Edge-1.5B-Chat | RK182X | 128 | 128 | 50.43 | 6.14 | 162.81 |
这一组的分布区间很清晰:
其中 Qwen2.5-7B 在单张 RK1828 上仍有 70.47 TPS,是目前端侧非常实用的一个平衡点:模型能力足以应付大多数对话、摘要与代码辅助任务,速度又完全不需要等待。而 Qwen3-8B 为 61.92 TPS,参数量更大、能力更强,速度只下降约 12%,也是值得优先考虑的档位。
单卡的容量天花板在 8B 附近。要跑 9B、12B、27B 乃至 31B,就需要多卡流水线并行级联:模型按层切分到多张 RK1828 上,由 RK3588 主控组织数据在卡间流转。
注意这一组的输入长度是 5120 tokens(远大于单卡的 128),所以它的 TTFT 不能和单卡组直接比较——这正是下一节要讲的第一个规律。
| 模型名称 | 加速芯片 | Input Tokens | New Tokens | TTFT (ms) | TPOT (ms) | Decode TPS |
|---|---|---|---|---|---|---|
| Gemma-4-12B | 2x RK1828 | 5120 | 128 | 7576.88 | 31.85 | 31.4 |
| Gemma-4-31B | 4x RK1828 | 5120 | 128 | 9077.22 | 70.03 | 14.28 |
| Qwen3.5-9B | 2x RK1828 | 5120 | 128 | 5910.11 | 30.23 | 33.08 |
| Qwen3.5-27B | 4x RK1828 | 5120 | 128 | 8718.15 | 76.57 | 13.06 |
| Qwen3.8-27B | 4x RK1828 | 5120 | 128 | 8699.48 | 76.45 | 13.08 |
几个关键读数:
另外,这一组的 TTFT 落在 5.9~9.1 秒。这个数字看着很大,但要结合输入长度理解:它是 5120 tokens 长提示词的「预填充」耗时,而不是空载延迟。
VLM 要同时处理图像和文本,所以表格多了一列 Vision(ms)——视觉编码耗时。按测试口径,Vision 与后面的 LLM 部分是独立测试的,因此 Vision 耗时可以理解为「图像理解」这一段本身的延迟。
| 模型 | 加速芯片 | Vision 分辨率 | Vision (ms) | TTFT (ms) | Decode TPS |
|---|---|---|---|---|---|
| FastVLM-1.5B | RK182X | 512 × 512 | 167.23 | 47.14 | 151.41 |
| InternVL3-2B | RK182X | 448 × 448 | 180.67 | 47.01 | 149.77 |
| InternVL3_5-4B | RK1828 | 448 × 448 | 175.21 | 106.09 | 88.94 |
| Qwen2.5-VL-3B | RK182X | 784 × 1176 | 227.43 | 93.37 | 51.23 |
| Qwen2.5-VL-3B | RK1828 | 392 × 392 | 216.90 | 83.16 | 104.76 |
| Qwen2.5-VL-7B | RK1828 | 784 × 1176 | 212.29 | 156.65 | 70.20 |
| Qwen3-VL-2B | RK182X | 384 × 384 | 105.57 | 53.73 | 147.33 |
| Qwen3-VL-4B | RK1828 | 384 × 384 | 108.23 | 106.92 | 89.95 |
| MiMo-VL-7B-RL | RK1828 | 784 × 1176 | 229.99 | 165.04 | 65.31 |
| MiniCPM-V-4 | RK1828 | 448 × 448 | 234.34 | 94.37 | 105.59 |
| SmolVLM-500M-Instruct | RK182X | 512 × 512 | 90.60 | 27.12 | 157.16 |
| SmolVLM2-500M-Video-Instruct | RK182X | 512 × 512 | 90.27 | 27.06 | 157.43 |
| LocateAnything-3B | RK182X | 448 × 448 | 228.70 | 92.00 | 102.80 |
关于 Qwen2.5-VL-3B 两行的差异:原始报告对此有专门说明——该模型在 RK1820 上采用两段式运行方案(LMHead 在 RK3588 上执行);在 RK1828 上则完全在协处理器端推理。两行的 Vision 分辨率也不同(784×1176 与 392×392),因此这两行的 TPS 差异(51.23 与 104.76)不能简单归因于芯片本身,而是「部署方案 + 输入分辨率」共同作用的结果。
VLM 的实用读数:
全模态(Omni)模型同时接收图像、音频和文本,因此表格里同时给出 Vision(ms) 与 Audio(ms) 两列,可以分别看出视觉和语音两条前端链路的开销。
| 模型 | 加速芯片 | Vision 分辨率 | Vision (ms) | Audio (ms) | TTFT (ms) | Decode TPS |
|---|---|---|---|---|---|---|
| Qwen2.5-Omni-3B(Thinker) | RK1828 | 392 × 392 | 217.82 | 97.37 | 83.47 | 104.23 |
| Qwen3-Omni | RK1828 | 384 × 384 | 149.40 | 63.60 | 112.70 | 86.20 |
| Qwen3.5-Omni | RK1828 | 384 × 384 | 91.20 | 39.00 | 157.80 | 62.30 |
| Gemma-4-E2B | RK182X | 384 × 384 | 55.60 | 102.88 | 88.16 | 75.30 |
| Gemma-4-E4B | RK1828 | 384 × 384 | 63.20 | 104.60 | 149.35 | 55.33 |
读这组数据的重点是「双前端开销」:
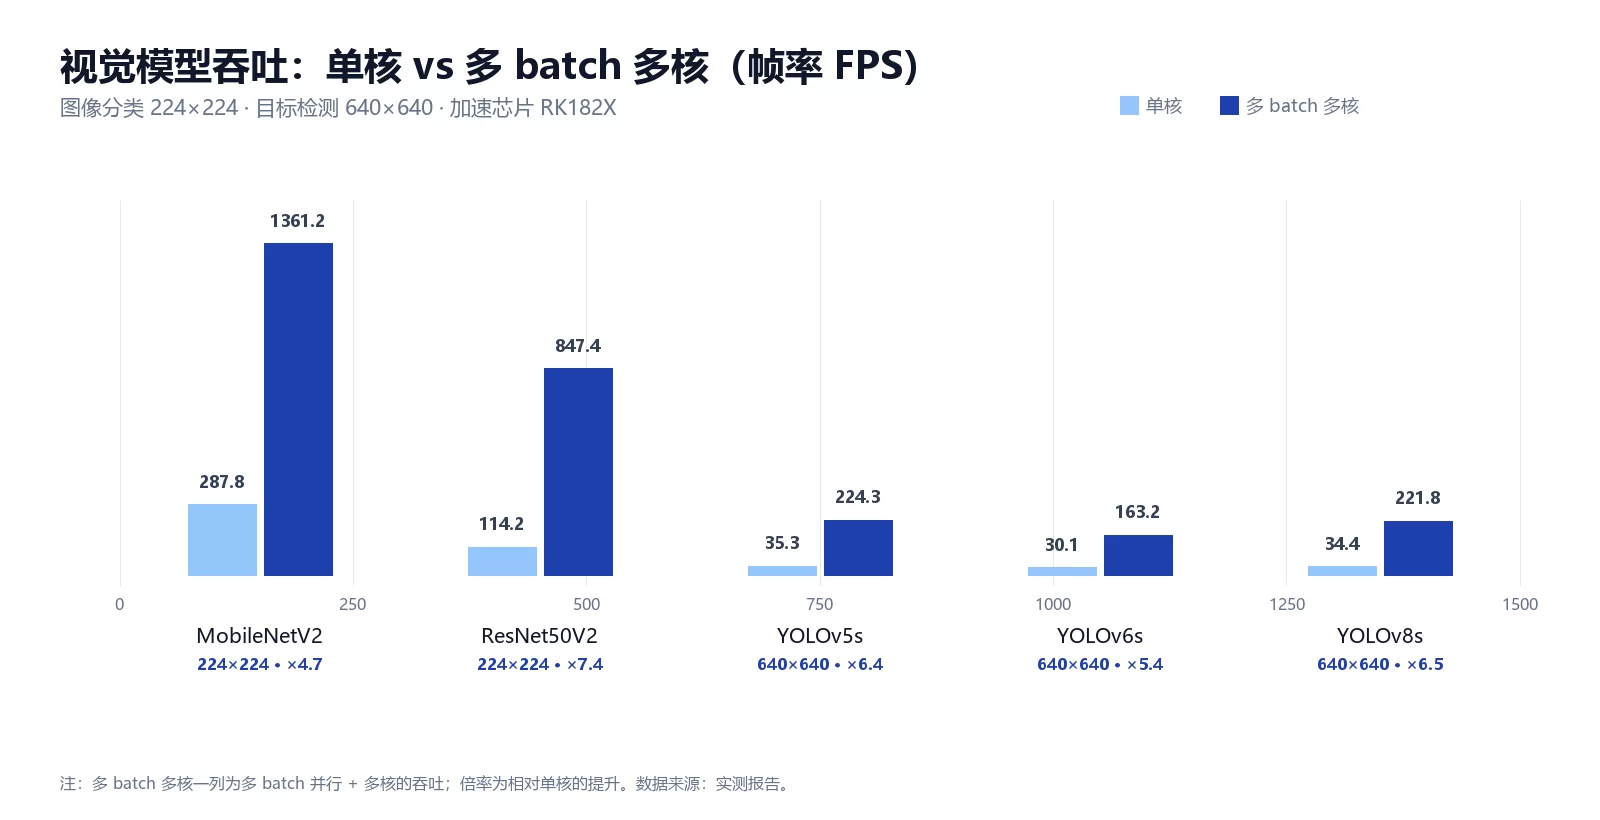
除了生成式模型,端侧还有大量判别式视觉任务——分类和检测。这类任务用帧率(FPS)衡量更直观,而且可以开多 batch、多核并行把吞吐拉起来。
| 任务 | 模型名称 | 加速芯片 | 分辨率 | 单核性能(帧率) | 多 batch 多核性能(帧率) | 提升倍率 |
|---|---|---|---|---|---|---|
| 图像分类 | MobileNetV2 | RK182X | 224 × 224 | 287.78 | 1361.2 | ×4.7 |
| ResNet50V2 | RK182X | 224 × 224 | 114.15 | 847.43 | ×7.4 | |
| 目标检测 | YOLOv5s | RK182X | 640 × 640 | 35.28 | 224.26 | ×6.4 |
| YOLOv6s | RK182X | 640 × 640 | 30.10 | 163.24 | ×5.4 | |
| YOLOv8s | RK182X | 640 × 640 | 34.38 | 221.79 | ×6.5 |
这组数据对工程选型非常有指导意义:
把两组数据放在一起看会非常清楚:单卡组输入 128 tokens,TTFT 只有 21.74~175.61 ms;多卡组输入 5120 tokens,TTFT 变成 5910~9077 ms。输入长度扩大 40 倍,首字延迟上升了约 50 倍。
工程含义:做交互式应用(对话、语音助手)时,要尽量控制提示词长度;而做长文档摘要、代码库分析这类「一次性长输入」任务时,应该预期数秒级的首字等待,并通过进度反馈、流式输出改善体感。
单卡数据里,0.5B 级别在 180~224 TPS,3B 级别约 90~104 TPS,7B~8B 仍在 61.92~70.47 TPS。也就是说从 3B 升到 8B,速度大约下降 30%~40%,但模型能力提升明显。对大多数端侧对话/文档场景,7B~8B 是性价比最高的选择。
数据里没有「单卡 27B」的条目,而是直接给出 4x RK1828 的 13.06~13.08 TPS(Qwen3.5-27B / Qwen3.8-27B)与 14.28 TPS(Gemma-4-31B)。这说明单卡容量上限约在 8B~9B,再往上就要靠流水线并行。
VLM 的 Vision 耗时集中在 90~235 ms,全模态的 Vision 在 55.60~217.82 ms、Audio 在 39.00~104.60 ms。换句话说,图像/语音前端的开销基本是「固定成本」,真正拉开差距的是后面 LLM 部分的解码速度。这也意味着:如果应用是「每帧都要过一次视觉编码」,那么视觉前端会是最需要优化的环节。
分类/检测这类「单次计算确定、可批量堆积」的任务,多 batch 多核收益巨大(MobileNetV2 ×4.7、ResNet50V2 ×7.4、YOLOv8s ×6.5)。而生成式模型受限于自回归解码的串行性,很难靠 batch 拿到同样的倍率——所以两类任务的优化思路完全不同:视觉任务堆并发,生成任务优化单路延迟与 KV Cache。
| 应用场景 | 推荐配置 | 依据(实测数字) |
|---|---|---|
| 本地对话助手 / 文档问答 | 单卡 RK1828 + 7B~8B | Qwen2.5-7B 70.47 TPS;Qwen3-8B 61.92 TPS,TTFT < 180 ms |
| 高并发轻量文本处理(分类、抽取、纠错) | 单卡 + 0.5B~1.5B | Qwen2.5-0.5B 224.19 TPS;GLM-Edge-1.5B 162.81 TPS |
| 翻译 / 垂直小模型 | 单卡 + 1B~2B 专用模型 | HY-MT1.5-1.8B 124.37 TPS |
| 图文问答 / 质检图像理解 | 单卡 + 3B~4B VLM | Qwen3-VL-4B 89.95 TPS(Vision 108.23 ms);InternVL3_5-4B 88.94 TPS |
| 视频抽帧理解 / 实时画面描述 | 单卡 + 轻量 VLM | SmolVLM2-500M-Video:Vision 90.27 ms、TTFT 27.06 ms、157.43 TPS |
| 语音 + 视觉 + 文本融合交互 | 单卡 RK1828 + Omni 模型 | Qwen2.5-Omni-3B:Vision 217.82 / Audio 97.37 ms、104.23 TPS |
| 9B~12B 中大型模型 | 双卡 RK1828 | Qwen3.5-9B 33.08 TPS;Gemma-4-12B 31.4 TPS |
| 27B~31B 大模型(离线/批处理) | 四卡 RK1828 | Qwen3.8-27B 13.08 TPS、TPOT 76.45 ms;Gemma-4-31B 14.28 TPS |
| 多路视频分析(分类/检测) | 单卡起,按路数扩多核 | YOLOv8s 34.38 → 221.79 FPS;MobileNetV2 287.78 → 1361.2 FPS |
为了避免误读,把原始报告中的测试口径完整列出:
读数提醒:① 单卡组输入 128 tokens、多卡组输入 5120 tokens,两组的 TTFT 不可直接横向比较;② 标注 RK182X 的行未区分 RK1820/RK1828,跨行比较需谨慎;③ Vision(ms)、Audio(ms) 与 TTFT 是独立测试结果,不能直接相加当作端到端延迟;④ 实际产品性能还会受到散热、内存带宽、模型量化方式与软件版本的影响,选型时建议以自己的业务数据复测为准。
如果正在评估 RK3588 + RK1828 方案能否承载自己的模型,可以把目标模型、上下文长度与并发路数发给我们,我们按这份测试口径帮你做一次针对性评估与实测。
.wrap{max-width:900px;margin:0 auto;font-family:-apple-system,BlinkMacSystemFont,”Segoe UI”,”PingFang SC”,”Microsoft YaHei”,sans-serif;line-height:1.78;color:#1f2937;}
.wrap h2{margin-top:36px;padding-left:10px;border-left:4px solid #2563eb;color:#111827;}
.wrap h3{margin-top:24px;color:#1e3a8a;font-size:17.5px;}
.wrap .cover{width:100%;max-width:900px;display:block;margin:18px auto;border-radius:8px;}
.wrap .lead{font-size:17px;color:#374151;}
.wrap .toc{background:#f3f4f6;border:1px solid #e5e7eb;border-radius:8px;padding:14px 20px;margin:20px 0;font-size:15px;}
.wrap .toc ol{margin:8px 0 0;padding-left:22px;columns:2;column-gap:28px;}
.wrap .toc li{margin:4px 0;}
.wrap .toc a{color:#2563eb;text-decoration:none;}
.wrap figure.fig{margin:20px 0;text-align:center;}
.wrap figure.fig img{width:100%;max-width:900px;border:1px solid #e5e7eb;border-radius:6px;display:block;margin:0 auto;}
.wrap figcaption{font-size:13.5px;color:#6b7280;margin-top:8px;text-align:left;line-height:1.6;}
.wrap table.spec{width:100%;border-collapse:collapse;margin:16px 0;font-size:14px;}
.wrap table.spec th,.wrap table.spec td{border:1px solid #d1d5db;padding:8px 10px;vertical-align:top;text-align:left;}
.wrap table.spec th{background:#eff6ff;color:#1e3a8a;font-weight:600;}
.wrap table.spec tr:nth-child(even) td{background:#f9fafb;}
.wrap table.spec td{white-space:nowrap;}
.wrap table.spec td:first-child{white-space:normal;}
.wrap ol{padding-left:24px;}
.wrap ol li{margin:7px 0;}
.wrap ul{margin:12px 0;padding-left:24px;}
.wrap li{margin:6px 0;}
.wrap .note{background:#eff6ff;border-left:4px solid #2563eb;padding:12px 16px;margin:18px 0;border-radius:0 8px 8px 0;color:#1e3a8a;}