20 TOPS 的 310B、67 TOPS 的 Orin Nano Super、6 TOPS 的 RK3588,怎么选才不踩坑。
按官方规格页逐项对照算力、内存带宽、视频编解码与工具链,单列 soc_version 的两种相反映射与第三方性能数字的口径差异,说明 TOPS 与 FPS 为什么不能直接横向换算。
硬件数据取自华为昇腾社区《Atlas 200I A2 加速模块 基本规格》、华为企业业务产品页与NVIDIA Jetson Orin Nano Super 开发者套件规格页;工具链与 SoC 映射取自 Ultralytics 官方 Ascend 集成文档;RK3588 与各类 FPS 数字标注为第三方口径,单独陈列、不与官方规格混用。核对日期 2026-11-12。
深圳市爱派派智能科技有限公司(爱派派智能)整理本选型资料,可提供边缘 AI 硬件选型评估与方案对接支持。文中商标与产品名归各自权利人所有,爱派派智能未宣称代理或授权关系,不含报价。
边缘 AI 选型最常见的误判,是把不同厂商的 TOPS 峰值或不同来源的 FPS 数字放进同一张表里排序。TOPS 是乘加单元的标称峰值,实际利用率取决于算子覆盖、内存带宽与编译器;FPS 则取决于模型、输入分辨率、量化方式、是否包含解码与后处理,以及是否计入数据拷贝。内容把官方规格、工具链与第三方数字分层列出,明确每一行能不能和另一行比较。
| 数字类型 | 适合回答什么 | 不适合回答什么 |
|---|---|---|
| INT8 TOPS 峰值 | 同一架构内的档位高低、量级初筛 | 跨架构的性能倍数、实际帧率 |
| 内存带宽 GB/s | 大模型或多路输入时的数据搬运瓶颈 | 算力利用率的具体数值 |
| 硬件解码路数 | 多路视频并发的接入能力 | 单路检测的延迟 |
| 纯模型推理 ms | 同模型同输入下的 NPU 执行效率 | 整机端到端帧率 |
| 端到端视频 FPS | 含解码与前后处理的实际业务吞吐 | 与纯推理 ms 直接换算 |
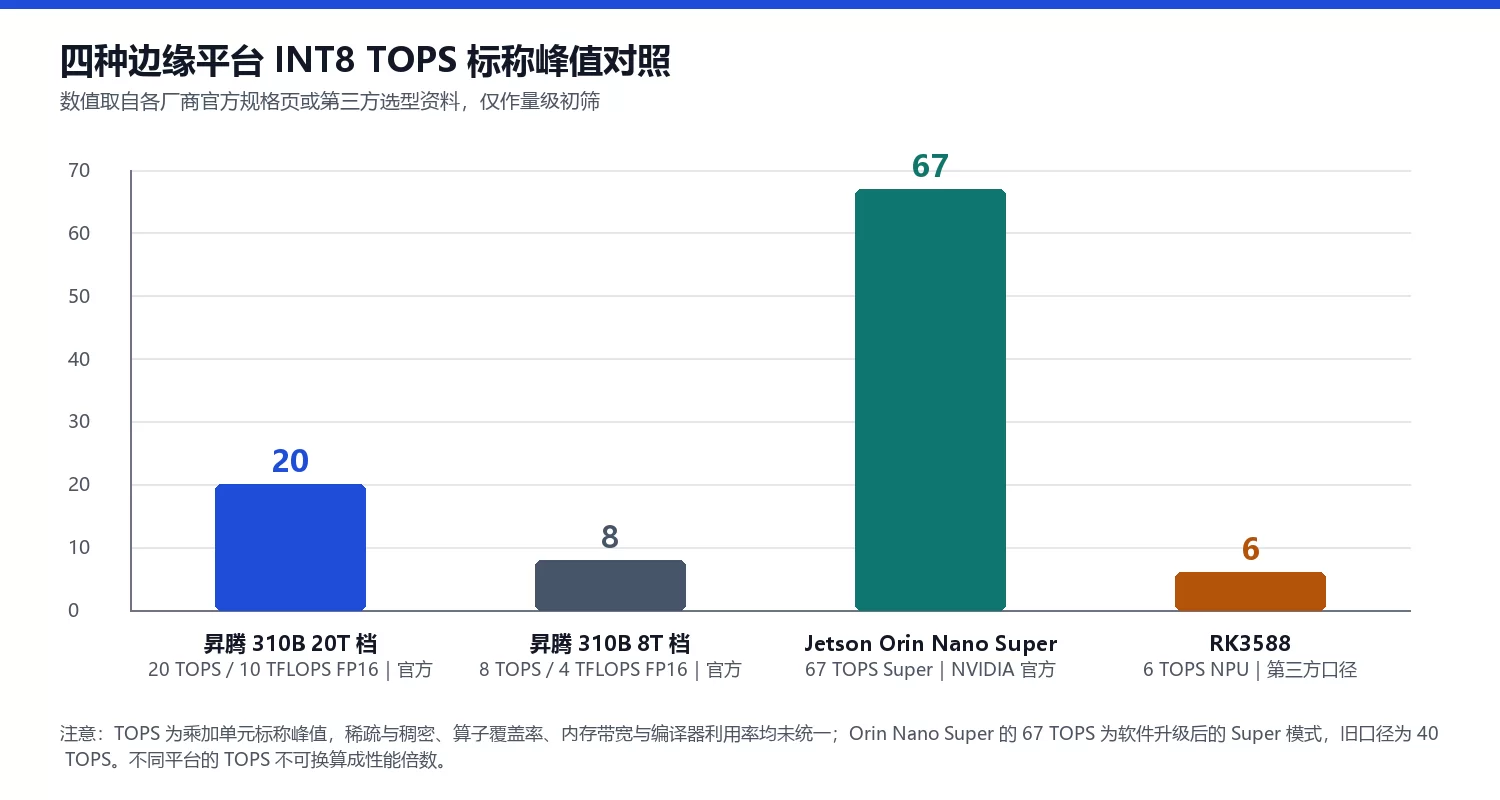
| 项目 | 昇腾 310B / Atlas 200I A2 20T | 昇腾 310B 8T 档 | Jetson Orin Nano Super | RK3588 |
|---|---|---|---|---|
| INT8 算力 | 20 TOPS | 8 TOPS | 67 TOPS(Super 模式) | 6 TOPS(第三方口径) |
| FP16 算力 | 10 TFLOPS | 4 TFLOPS | 官方规格页未单列 | 未标注 |
| AI 核心 | 1×DaVinciV300,1.224GHz | 1×DaVinciV300,0.5GHz | 1024 CUDA + 32 Tensor Core(Ampere) | NPU 3 核(第三方口径) |
| CPU | 4×TaishanV200M,1.6GHz | 4×TaishanV200M,1.0GHz | 6×Cortex-A78AE | 4×A76 + 4×A55 |
| 内存 | LPDDR4X 4 / 8 / 12GB,支持 ECC | LPDDR4X 4GB,支持 ECC | 8GB 128bit LPDDR5 | 按板卡配置,常见 4/8/16GB |
| 内存带宽 | 51.2 / 34.1 / 25.6 GB/s(按容量) | 25.6 GB/s | 102 GB/s | 第三方口径约 17.1 GB/s |
| H.264/H.265 解码 | 40 路 1080P 30FPS;4 路 4K 75FPS | 20 路 1080P 30FPS;2 路 4K 75FPS | 官方规格页未在本表口径内列出 | 8K30 等按第三方资料 |
| H.264/H.265 编码 | 20 路 1080P 30FPS | 12 路 1080P 30FPS | 未标注 | 未标注 |
| 功耗 | 开发者套件典型 24W(整机) | 未单列 | 7–25W | 5–10W(第三方整机口径) |
| 数据来源 | 华为昇腾社区 / 企业业务产品页 | 华为昇腾社区 | NVIDIA 官方规格页 | 第三方选型资料 |
关于功耗与内存的口径:24W 是某款 Atlas 200I DK A2 开发者套件标注的典型整机功耗,不是芯片裸片功耗;Orin Nano Super 的 7–25W 是模组功耗区间。二者统计对象不同,不应直接比大小。昇腾 310B 的内存容量与带宽按 SKU 分档,表中按官方顺序对应列出。
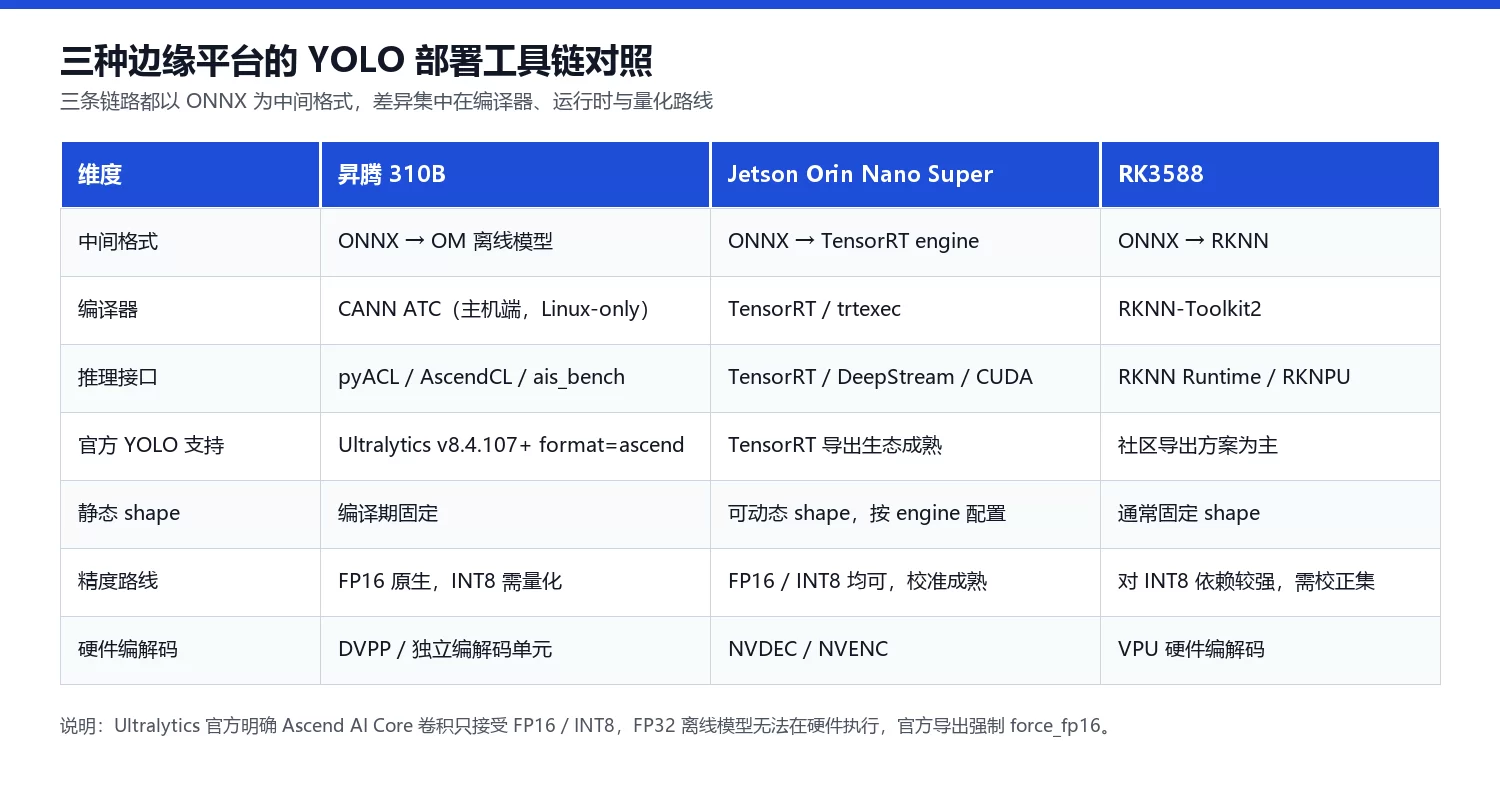
| 维度 | 昇腾 310B | Jetson Orin Nano Super | RK3588 |
|---|---|---|---|
| 中间格式 | ONNX → OM 离线模型 | ONNX → TensorRT engine | ONNX → RKNN |
| 编译器 | CANN ATC(主机端,Linux-only) | TensorRT / trtexec | RKNN-Toolkit2 |
| 推理接口 | pyACL / AscendCL / ais_bench | TensorRT / DeepStream / CUDA | RKNN Runtime / RKNPU |
| 官方 YOLO 支持 | Ultralytics v8.4.107+ 提供 format=ascend | TensorRT 导出生态成熟 | 社区导出方案为主 |
| 静态 shape | 编译期固定,运行时不协商 | 可动态 shape,按 engine 配置 | 通常固定 shape |
| 精度路线 | FP16 原生支持,INT8 需量化 | FP16 / INT8 均可,校准工具成熟 | 对 INT8 依赖较强,需校正集 |
| 硬件视频编解码 | DVPP / 独立编解码单元 | NVDEC / NVENC | VPU 硬件编解码 |
| 生态语言 | CANN 文档完善,生态相对独立 | CUDA 生态成熟,第三方案例多 | 国内文档与社区案例较多 |
| 来源 | Ascend310B1 | Ascend310B4 | 备注 |
|---|---|---|---|
| Ultralytics 官方 Ascend 集成文档 | OrangePi AIPro 8T | OrangePi AIPro 20T、Atlas 200I A2 | name 参数直接作为 –soc_version 传给 ATC |
| 第三方 310B 开发规范(GitHub) | 20T 档建立独立证据集 | 8T 档建立独立证据集 | 与上表映射相反,并要求两档性能数字不得混用 |
| 用户提供的第三方部署指南 | ATC 固定使用 Ascend310B1 | 未使用 | 未说明对应档位,复现前需确认 |
| 处理方式 | 不判定谁对 | 不判定谁对 | 以 npu-smi info + 匹配 kernels 包 + 实际 ATC 编译通过为准 |
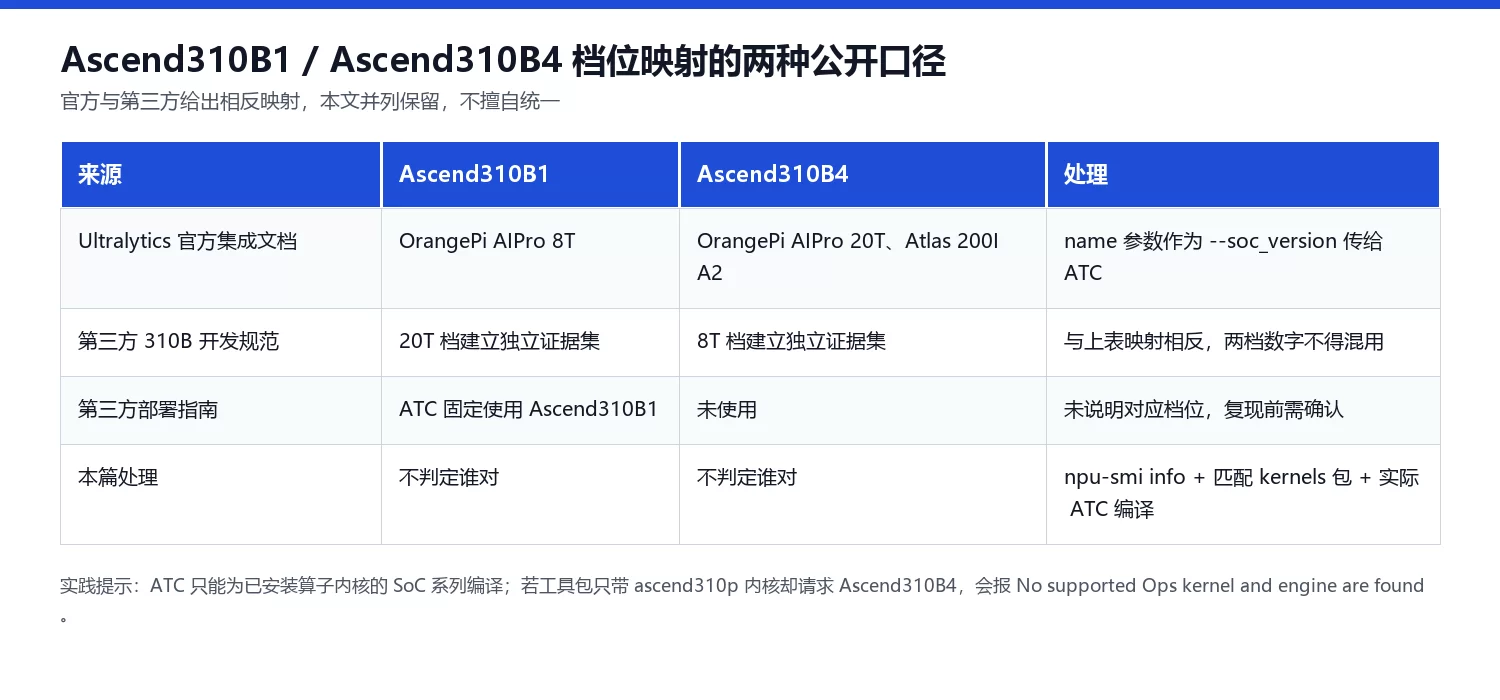
实践提示:Ultralytics 官方明确,ATC 只能为已安装算子内核的 SoC 系列编译;若工具包只带 ascend310p 内核而请求 Ascend310B4,会报 No supported Ops kernel and engine are found。因此档位判定的完整动作是:npu-smi info 看芯片 → 安装对应 Ascend-cann-kernels 包 → 跑一次 ATC 编译。
| 平台 | 常见精度路线 | 对工程的影响 |
|---|---|---|
| 昇腾 310B | FP16 原生支持(10 TFLOPS FP16),Ultralytics 官方 Ascend 导出为 FP16-only | 从 FP32 训练权重转换时精度损失通常较小;官方导出强制 –precision_mode=force_fp16 |
| Jetson Orin Nano Super | FP16 / INT8 均可,TensorRT 层融合与 INT8 校准工具成熟 | 追求吞吐可做 INT8 量化并校准;通用浮点能力较强 |
| RK3588 | 第三方实践反馈对 INT8 依赖强 | 量化校正数据集质量直接影响精度,需要额外准备与验证 |
「FP16 支持更强」属于第三方工程经验,不是官方精度承诺。Ultralytics 官方文档给出的硬约束是:Ascend AI Core 的卷积只接受 DT_FLOAT16 与 DT_INT8 张量,FP32 离线模型无法在硬件上执行,因此其 Ascend 导出会强制 FP16 并拒绝 quantize=32。这条约束比任何经验判断都更值得先满足。
| 能力 | 20T 档官方规格 | 8T 档官方规格 |
|---|---|---|
| H.264 / H.265 解码 | 40 路 1080P 30FPS;4 路 4K 75FPS | 20 路 1080P 30FPS;2 路 4K 75FPS |
| H.264 / H.265 编码 | 20 路 1080P 30FPS;3 路 4K 50FPS | 12 路 1080P 30FPS;2 路 4K 50FPS |
| JPEG 解码 | 1080P 512FPS | 1080P 512FPS |
| JPEG 编码 | 1080P 256FPS | 1080P 256FPS |
| 最大分辨率 | 16384×16384(官方规格) | 16384×16384(官方规格) |
编解码是独立硬件单元,不占 AI Core 算力,也不占 CPU 通用算力。昇腾社区一篇 Atlas 310 部署实战提到,把 OpenCV 软解码换成 DVPP 硬件解码并解耦线程后,视频流帧率从约 4 FPS 提升到约 22 FPS。这说明多路视频场景的瓶颈常在解码而非 NPU 本身,但该数字是特定案例的端到端结果,不能当作 310B 的通用性能上限。
| 来源 | 数字 | 模型 / 输入 | 统计边界 | 可否与别行比较 |
|---|---|---|---|---|
| 第三方部署指南示例输出 | 15.421 ms / 64.85 FPS | YOLOv8n,640×640,batch=1 | warmup=3、loop=20 的纯 model.infer 平均,含 H2D/D2H 拷贝 | 仅可与同模型同边界的纯推理耗时比 |
| 昇腾社区 Atlas 310 部署实战 | 约 4 FPS → 约 22 FPS | YOLOv8 视频流,分辨率未标注 | 端到端视频流,优化点为 DVPP 硬件解码 | 仅可与端到端视频流场景比 |
| 第三方具身智能选型表 | 约 60–80 FPS | YOLOv8s,1080P,INT8 | 选型估测,非实测 | 不可作为实测依据 |
| 第三方 AI 硬件配置指南 | 约 20 FPS,延迟 ≤50ms | YOLOv10-s(原文口径) | 选型估测,且把 310B 算力写为 16 TOPS | 不可采信算力口径 |
| 华为官方规格页 | 20 / 8 TOPS INT8 | 不适用 | 芯片标称峰值,非实测帧率 | 不可与 FPS 换算 |
口径诚实标注:上表五行来自不同来源、不同模型、不同分辨率与不同统计边界。没有在目标板上复测任何一项,也不把这些数字合并成一条结论。工程立项请以自有模型、自有码流在目标板上的端到端压测为准,并在验收记录里写清 warmup 次数、是否含解码、是否含 NMS 与是否含 H2D/D2H 拷贝。
| 场景 | 昇腾 310B | Jetson Orin Nano Super | RK3588 |
|---|---|---|---|
| 已有 CUDA / TensorRT 代码 | 需改写为 CANN / pyACL 或 AscendCL | 迁移成本最低 | 需改写为 RKNN |
| 国产化与自主可控要求 | 官方全栈方案,适配性较好 | 境外生态 | 国内方案 |
| 多路视频接入 | 硬件解码路数明确,40 路 / 20 路 | 按 JetPack 与 DeepStream 配置 | 按 VPU 能力配置 |
| Transformer / 生成式小模型 | 可跑,但通用性弱于 GPU | CUDA 通用计算能力突出 | 受限较多 |
| 文档与案例 | 官方文档完善,生态相对独立 | 全球案例最多 | 国内社区案例较多 |
| 量化准备 | FP16 起步较省力 | INT8 校准工具成熟 | 校正数据集要求较高 |
| 项目需求 | 优先考虑 | 理由 | 需要额外验证 |
|---|---|---|---|
| 多路摄像头视频分析、安防巡检 | 昇腾 310B 20T 档 | 官方标称 40 路 1080P30 硬件解码,编解码不占 AI Core | 实际码流、并发路数与整机散热 |
| 国产化 / 自主可控合规项目 | 昇腾 310B | CANN 全栈与国内文档支持 | 目标 SoC 档位与 kernels 包匹配 |
| 通用 GPU 计算、机器人、Transformer | Jetson Orin Nano Super | 67 TOPS、102GB/s、CUDA 生态成熟 | 功耗模式与散热条件下的持续性能 |
| 成本敏感、低功耗单路检测 | RK3588 或 310B 8T 档 | 整机成本与功耗较低 | INT8 量化精度与校正集 |
| 教学 / 科研原型 | 按已有工具链选 | 三者都有 YOLO 部署案例 | 不要复用别人的 FPS 数字做验收指标 |
| 类别 | 关键词 |
|---|---|
| 平台与型号 | 华为昇腾 310B、Ascend 310B、Atlas 200I A2、Atlas 200I DK A2、Jetson Orin Nano Super、RK3588、OrangePi AIPro |
| 算力与规格 | 20 TOPS INT8、10 TFLOPS FP16、8 TOPS、4 TFLOPS、67 TOPS、6 TOPS、LPDDR4X、LPDDR5、102GB/s、51.2GB/s、ECC、7–25W |
| 工具链 | CANN、ATC、OM、pyACL、AscendCL、ais_bench、JetPack、TensorRT、DeepStream、RKNN-Toolkit2、format=ascend、v8.4.107 |
| SoC 与精度 | Ascend310B1、Ascend310B4、Ascend310P1、Ascend310P3、–soc_version、force_fp16、quantize=32、FP16-only、INT8 量化、校正数据集 |
| 视频与性能 | 40 路 1080P30、20 路 1080P30、DVPP、NVDEC、硬件解码、端到端 FPS、纯推理耗时、H2D、D2H、warmup |
| 选型 | 边缘 AI 选型、多路视频分析、国产化、自主可控、CUDA 生态、模型迁移、口径辨析、爱派派智能 |
A:不能这样换算。两者都是 INT8 TOPS 标称峰值,但架构不同:310B 是达芬奇架构 AI Core,Orin Nano 是 Ampere GPU 的 Tensor Core;稀疏与稠密、算子覆盖、内存带宽、编译器的实际利用率都不一样。TOPS 只适合初筛量级,最终必须拿自己的模型、分辨率与 batch 在两块板上实测端到端帧率。
A:官方规格页同时列出两个档位:20 TOPS INT8 / 10 TFLOPS FP16 与 8 TOPS INT8 / 4 TFLOPS FP16,对应不同的 AI Core 主频、CPU 主频、内存容量与带宽以及编解码路数。这不是同一块板的两种写法,而是产品档位差异,选型时必须确认具体 SKU 与 Board ID。
A:第三方文章里出现过 220 TOPS INT8 / 110 TFLOPS FP16 的写法,与华为官方 20 TOPS / 10 TFLOPS 相差一个数量级,疑为排版或转录错误。规格以华为昇腾社区与企业业务产品页的公开资料为准,并把第三方数字单独列入口径差异表,不采信为选型依据。
A:公开资料冲突:Ultralytics 官方集成文档写 Ascend310B4 对应 OrangePi AIPro 20T 与 Atlas 200I A2、Ascend310B1 对应 OrangePi AIPro 8T;另有第三方 310B 开发规范给出相反映射。两组数字并列列出。工程上以板端 npu-smi info、已安装的 kernels 包以及一次真实 ATC 编译通过作为判据。
A:第三方部署实践普遍指出:昇腾 310B 对 FP16 支持较强,从 PyTorch FP32 经 ONNX 到 OM 时很多参数不必强制量化;RK3588 的 RKNN 路线对 INT8 依赖更强,需要仔细制作量化校正数据集。这属于第三方工程经验而非官方精度承诺,实际精度损失仍要用自有验证集实测。
A:官方规格给出 20 TOPS 档支持 H.264/H.265 硬件解码 40 路 1080P 30FPS、编码 20 路 1080P 30FPS,8 TOPS 档为解码 20 路、编码 12 路。编解码是独立硬件单元,不占用 AI Core 算力。因此在多路视频分析场景,310B 的优势不在峰值 TOPS,而在解码路数。
A:不能。这里的 64.85 FPS 来自 YOLOv8n@640 纯模型推理(含 H2D/D2H 拷贝),22 FPS 来自昇腾社区 Atlas 310 案例改用 DVPP 硬件解码后的端到端视频流,60–80 FPS 是第三方选型文章对 310B 的估测(YOLOv8s@1080P INT8)。模型、分辨率、量化方式与统计边界都不同,分三行列示,不合并、不换算。
深圳市爱派派智能科技有限公司(爱派派智能)
地址:深圳市坪山区创新广场C栋1805
电话:18681465731
联系人:李先生
官网:https://ai-paipai.com
说明:内容由第三方部署指南整理,并按华为昇腾社区、Ultralytics 与 NVIDIA 官方公开资料复核,已去除原厂品牌、二维码与联系方式,配图为自绘;爱派派智能未宣称代理或授权关系,不含报价,不替代原厂官方文档与目标板实测。