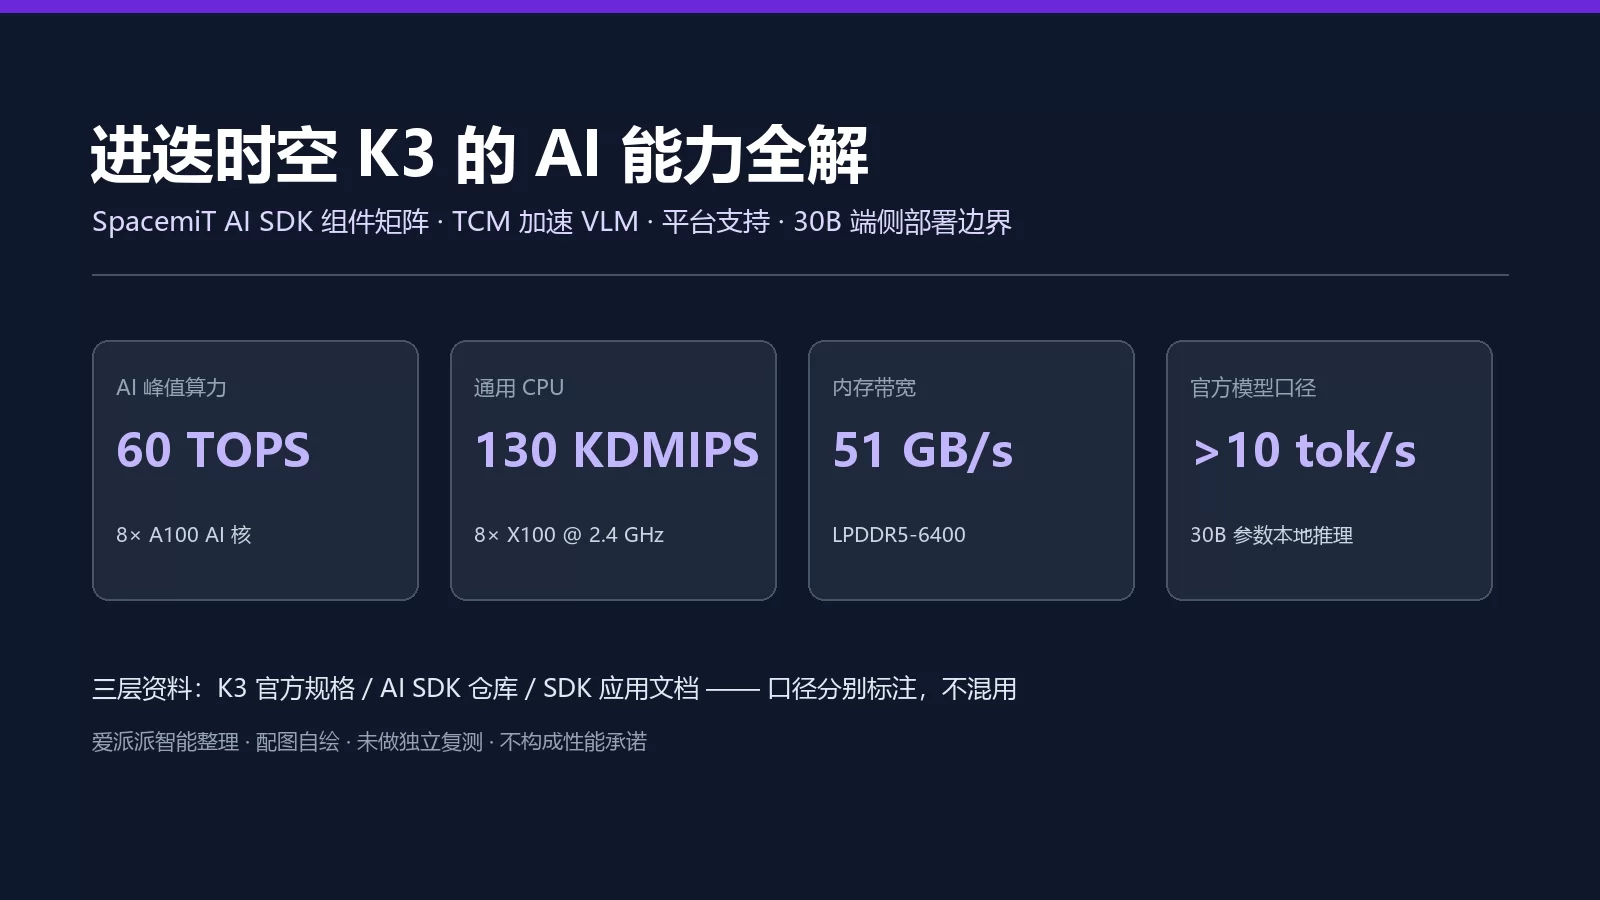
进迭时空 K3 的 AI 能力:把芯片规格、AI SDK 组件、平台支持与服务化接口放在一张图里看清楚。
内容不是把 GitHub README 翻译一遍,而是按「芯片硬件 → SDK 组件 → 平台支持 → 运行命令 → 服务化接入 → 场景边界」重新组织的 K3 AI 能力索引。仓库没写、官方文档写了的内容标注来源;官方与第三方数字不一致的地方并列列出。
K3 的强项是把 60 TOPS 通用 AI 算力、51 GB/s 内存带宽与多路视频输入放在同一颗 RISC-V 芯片上;AI SDK 则把视觉、语音、LLM/VLM、数字人、文档解析和强化学习收拢到统一接口,其中 VLM 明确面向 K3 等平台并通过 TCM 加速。SDK 文档标记 K3 不支持 OpenHarmony,仓库速度表也没有注明测试条件。
关于「K3 的 AI 能力」,公开资料分布在三个层级:芯片规格、SDK 仓库、SDK 应用文档。三者口径并不完全重叠,混着引用容易把「仓库自述」写成「K3 官方实测」。先划清三层资料的边界,再展开能力清单。
| 层级 | 资料 | 能支撑的结论 | 不能推出的结论 |
|---|---|---|---|
| 芯片规格 | K3 产品页 / 用户手册 / 数据手册 | 60 TOPS、8×X100 + 8×A100、精度格式、内存与多媒体接口 | 具体模型吞吐、SDK 命令是否可用 |
| SDK 仓库 | spacemit-com/ai-sdk 的 README 与子模块清单 | 组件清单、构建命令、示例命令、VLM 模型与仓库自述速度 | 逐款芯片支持矩阵、未注明条件的速度归属到某款板卡 |
| 应用文档 | AI SDK 中文文档(平台支持表与 VLM/网关章节) | K3 支持 Buildroot / Bianbu、不支持 OpenHarmony;VLM 面向 K3 等平台并启用 TCM | 替代芯片官方规格书 |
时间与许可:仓库最后推送时间为 2026-11-16,默认分支 main,许可证 Apache-2.0;核对日期 2026-11-18。仓库通过 Git Submodule 聚合组件,不把子模块内容当成主仓库原创。
| 子系统 | 官方规格 | 对 AI 应用的含义 |
|---|---|---|
| CPU | 8× X100 64-bit RISC-V,四发射乱序,最高 2.4 GHz,共 130 KDMIPS,单核 SpecINT2006 > 9.0/GHz,8 核共享 8 MB L2 | 承担控制、数据预处理与通用计算,指令集兼容常规 CPU 编程范式 |
| AI 计算 | 8× A100 AI 核,60 TOPS 通用 AI 算力;支持 BF16 / FP16 / FP8 / INT8 / INT4 | A100 支持最高 1024-bit RVV 1.0 向量处理,专用 TCM 与 DMA 加速 |
| 模型能力 | 官方称可流畅运行 300 亿参数模型,>10 tokens/s @ 30B | 面向 30B 级端侧推理;实际速度受内存带宽与量化影响 |
| 内存 | 64-bit LPDDR5-6400 / LPDDR4x-4266,带宽最高 51 GB/s;产品简介写最高 32 GB | 统一内存容量决定可装载模型规模,带宽影响 decode |
| 多媒体 | 4K@180fps 解码、4K@90fps 编码;双 3840×2160@60fps 显示输出;4×MIPI-CSI 共 12 lane,最多 12 路摄像头 | 适合多路视觉输入 + 本地推理的一体化设备 |
| 扩展 | 8×PCIe Gen3 lane(8 Gbps/lane,RC/EP)、3×USB3.0 Host + 1×USB3.0 DRD、4×GMAC(TSN) | 可接 NVMe、加速卡与多路网络 |
| 功耗与环境 | TDP 15–25 W;工业级 −40℃ 至 +85℃ | 需按整机散热与供电预算评估,而非只看芯片峰值 |
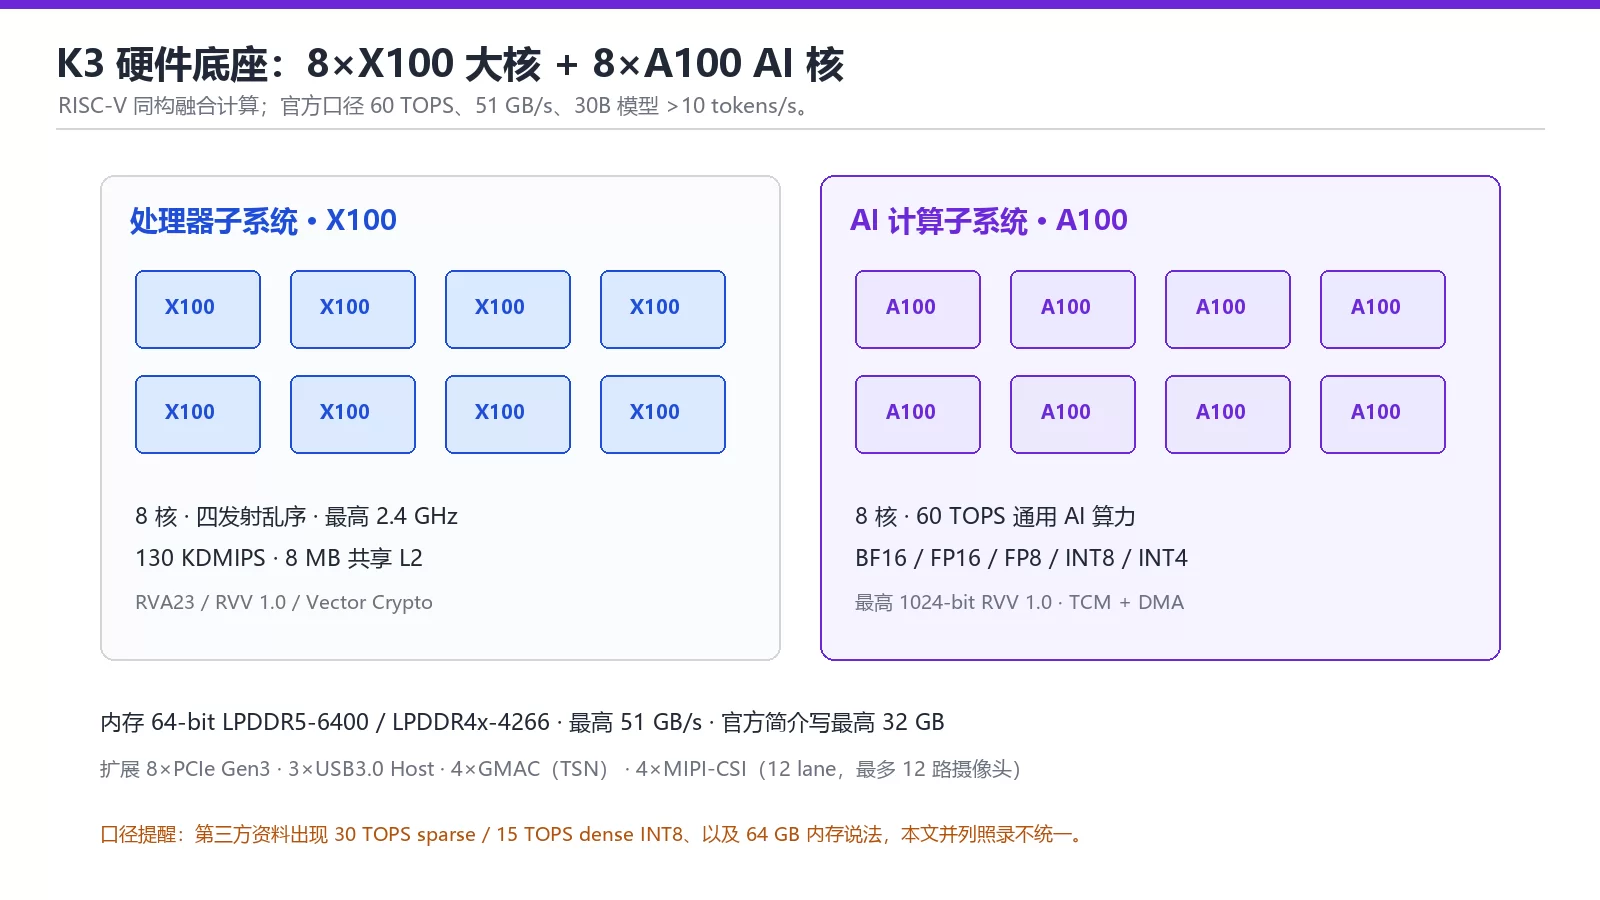
口径差异,不擅自统一:官方产品页给出「60 TOPS」与「最高 32 GB 内存」;另有第三方技术文章给出「30 TOPS sparse / 15 TOPS dense INT8」,K3 数据手册的中文摘要则出现「最大支持 64GB 内存容量」。这些数字可能对应不同精度、稀疏性或封装配置,这里并列照录,选型时应以对应板卡的内存焊接规格与 SDK 实测为准。
| 口径 | 数值 / 表述 | 来源层级 | 这里的处理 |
|---|---|---|---|
| AI 峰值算力 | 60 TOPS 通用 AI 算力 | 官方产品页 / 用户手册 | 主口径 |
| AI 峰值算力 | 30 TOPS sparse / 15 TOPS dense INT8 | 第三方技术文章 | 并列标注,不覆盖官方值 |
| 内存容量 | 最高 32 GB | 官方产品简介 / 用户手册 | 主口径 |
| 内存容量 | 最大支持 64 GB | K3 数据手册中文摘要 | 并列标注,不擅自解释为同一配置 |
| 智能水平 | 综合智力性能是 235B 模型的 84% | 官方产品页 | 官方评价口径,未给评测方法,不作为独立结论 |
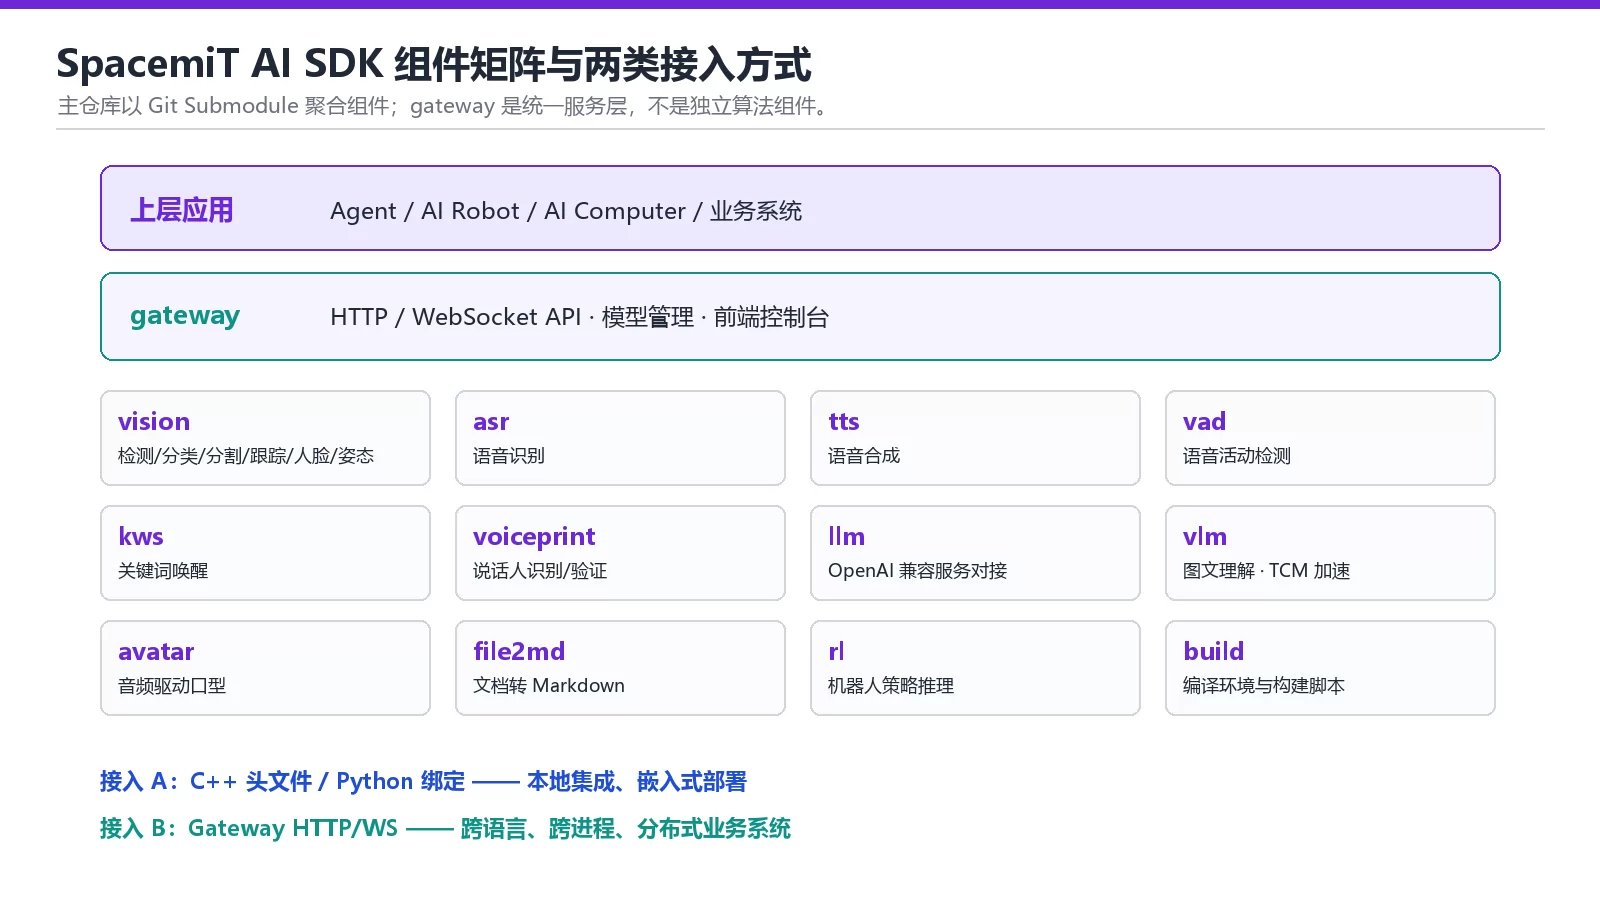
仓库把能力拆成 Git 子模块,每个组件独立演进、按需拉取。主仓库根目录就是组件目录,形成「基础能力组件 + 统一服务层」的结构。
| 组件目录 | 能力 | 对外入口 / 备注 |
|---|---|---|
| vision | 检测、分类、分割、跟踪、人脸、姿态等 | vision/include/vision_service.h;C++/Python 统一接口 |
| asr | 语音识别 | asr/include/asr_service.h;提供文件与流式 demo |
| tts | 语音合成 | tts/include/tts_service.h;支持指定文本与后端 |
| vad | 语音活动检测 | vad/include/vad_service.h;内置模拟音频示例 |
| kws | 关键词唤醒 | kws/include/kws_service.h;仓库子模块清单中包含 |
| voiceprint | 说话人识别 / 验证 / 嵌入提取 | 默认 CamP+(3D-Speaker),模型缓存到 ~/.cache/models/vp/campplus/ |
| llm | 对接 OpenAI 兼容服务 | llm/include/llm_service.h;llm_chat 示例 |
| vlm | 视觉语言模型、图像描述、视觉问答、多轮图文对话 | vlm/include/vlm/vlm_service.h;C++ / Python HTTP 接口 |
| avatar | 音频驱动口型,离线生成说话画面 | FeatherHuBERT + 人物 UNet |
| file2md | PDF / Office / 图片 / 网页转 Markdown | 版面分析、OCR、公式/表格/流程图识别 |
| rl | 机器人策略推理 | YAML 配置解析、观测组装、ONNX 推理、动作映射 |
| gateway | 统一 HTTP/WS 服务层与前端控制台 | 不是算法组件,基于上述能力之上封装 |
| 平台 / 系统 | K1 | K3 | 对开发的含义 |
|---|---|---|---|
| Buildroot | 支持 | 支持 | 适合裁剪的嵌入式镜像 |
| OpenHarmony | 不支持 | 不支持 | SDK 文档口径,需另评估其他移植路径 |
| Bianbu LXQT / GNOME | 支持 | 支持 | 适合带桌面的 AI 计算机与快速验证 |
这张平台表是判断「能不能直接照文档跑」的关键:后面所有命令默认运行在 K3 的 Buildroot 或 Bianbu 环境,不把 OpenHarmony 环境当作已验证前提。
| 步骤 | 命令 / 位置 | 说明 |
|---|---|---|
| 1 拉源码 | git clone –recurse-submodules … | 组件以 submodule 管理,必须递归拉取 |
| 2 补拉子模块 | git submodule update –init –recursive | 适用于已 clone 主仓库但没拉子模块的情况 |
| 3 初始化环境 | source build/envsetup.sh | 编译前必须先执行 |
| 4 一键编译 | m | 首次编译会安装组件依赖,耗时更长 |
| 5 单组件编译 | cd asr && mm(或 vision/tts/vad/llm/vlm/voiceprint/rl) | 先 source 环境再进目录 |
| 6 产物位置 | output/staging | 具体路径以 SDK 工程配置为准 |
# 递归拉取(推荐)
git clone --recurse-submodules https://github.com/spacemit-com/ai-sdk.git

# 已 clone 但缺少子模块时
cd ai-sdk
git submodule update --init --recursive

# 初始化环境并一键编译
source build/envsetup.sh
m

# 只编译单个组件(同样需要先 source build/envsetup.sh)
cd vlm && mm组件定位提醒:gateway 不建议简单当作一个 mm 算法组件,它包含 Python 服务、HTTP/WS API、前端控制台与 Debian 打包流程;生产部署推荐使用 Debian 包安装 spacemit-ai-gateway。
| 能力 | 示例入口 | 默认资源位置 |
|---|---|---|
| 人脸识别(相似度) | arcface + arcface.yaml | 模型 ~/.cache/models/vision/,素材 ~/.cache/assets/ |
| 人脸检测 | yolov5-face + yolov5-face.yaml | 模型 ~/.cache/models/vision/,素材 ~/.cache/assets/ |
| 手势检测 | yolov5_gesture + yolov5_gesture.yaml | 模型 ~/.cache/models/vision/,素材 ~/.cache/assets/ |
| 目标检测 | yolov8 / yolov11 + 对应 yaml | 模型 ~/.cache/models/vision/,素材 ~/.cache/assets/ |
| 姿态估计 | yolov8_pose | 模型 ~/.cache/models/vision/,素材 ~/.cache/assets/ |
| 实例分割 | yolov8_seg | 模型 ~/.cache/models/vision/,素材 ~/.cache/assets/ |
| 图像分类 / 情绪识别 | resnet / emotion | 模型 ~/.cache/models/vision/,素材 ~/.cache/assets/ |
| 多目标跟踪 | bytetrack / ocsort | 需接屏幕,否则实时显示示例会报错 |
bash vision/scripts/download_all_models.sh
bash vision/scripts/download_assets.sh

arcface vision/examples/arcface/config/arcface.yaml
yolov8 vision/examples/yolov8/config/yolov8.yaml
yolov11 vision/examples/yolov11/config/yolov11.yaml
bytetrack vision/examples/bytetrack/config/bytetrack.yaml| 语音能力 | 示例命令 | 前置条件 |
|---|---|---|
| ASR 文件识别 | asr_file_demo ~/.cache/models/assets/audio/001_zh_daily_weather.wav | 下载示例 wav |
| ASR 流式识别 | asr_stream_demo -l;asr_stream_demo -i 0 -t 5 | 需外部音频输入设备 |
| TTS 文件合成 | tts_file_demo;tts_file_demo -p 你好世界 -l matcha:zh | 默认参数或指定中文后端 |
| TTS 流式合成 | tts_stream_demo -o 0 –output 48000 –channels 2 -e matcha:zh-en | 需外部音频输出设备 |
| VAD | vad_simple_demo | 内置模拟音频即可 |
| 声纹识别 | register_speaker -n manbo |
CamP+ 模型首次运行自动下载 |
这组 demo 的价值在于把「视觉 / 语音 / 声纹」拆成可单模块验证的步骤:先确认模型与素材能下载、示例能跑通,再谈上层 Agent 或机器人链路。
llm 组件本身不做模型推理,而是对接 OpenAI 兼容服务。本地路径是 llama-server 加载 GGUF 模型并开端口;远端路径只需换 api_base 并通过环境变量传密钥。
mkdir -p ~/.cache/models/llm
cd ~/.cache/models/llm
wget https://archive.spacemit.com/spacemit-ai/model_zoo/llm/qwen2.5-0.5b-instruct-q4_0.gguf

# 启动 OpenAI 兼容服务(8080)
llama-server -m ~/.cache/models/llm/qwen2.5-0.5b-instruct-q4_0.gguf -t 8 --port 8080 &

# 调用 SDK 示例:问题 / api_base / 模型名 / system prompt / max_tokens
llm_chat "你好" "http://localhost:8080/v1" "qwen2.5-0.5b" "你是一个有帮助的助手。" 256export OPENAI_API_KEY=your_api_key
llm_chat "你好" "https://api.deepseek.com" "deepseek-chat" "你是一个有帮助的助手。" 256| 调用面 | 本地 | 云端 / 远端 |
|---|---|---|
| api_base | http://localhost:8080/v1 | 服务商地址,例如 https://api.deepseek.com |
| 模型文件 | GGUF,例如 qwen2.5-0.5b-instruct-q4_0.gguf | 由服务端决定 |
| 密钥 | 通常不需要 | OPENAI_API_KEY 环境变量 |
| 数据边界 | 全部留在本机 | 提示词与上下文出本机,需评估合规 |
| SDK 侧改动 | 无,仍调用同一 llm_chat 示例 | 无,仅换第二参数 |
参数口径:llm_chat 的五个位置参数依次为问题、api_base、模型名、system prompt 与最大 token 数。示例里的 -t 8 是 llama-server 的线程数,不等于只能用 8 个 CPU 核;具体最优值需在目标板上实测。
VLM 是这套 SDK 里与 K3 关联最明确的部分。中文文档写明:该组件面向 K3 等 RISC-V 平台,支持图像描述、视觉问答、多轮图文对话,通过 llama-server HTTP API 调用 TCM(Tensor Compute Module)硬件加速,并提供 C++ 原生接口、Python HTTP 封装与 Gateway 适配层。
| 模型 ID | 参数量 | 磁盘大小 | 仓库自述推理速度 | 说明 |
|---|---|---|---|---|
| fastvlm-mm-0.5b-q4_1 | 0.5B | ~766M | ~58 tok/s | 轻量级 VLM,默认后端 |
| Qwen3.5-0.8B | 0.8B | ~932M | ~40 tok/s | Qwen3.5 视觉语言模型 |
| Qwen3.5-2B | 2B | ~2.6G | ~26 tok/s | Qwen3.5 视觉语言模型 |
| Qwen3.5-4B | 4B | ~3.9G | ~13 tok/s | Qwen3.5 视觉语言模型 |
| qwen30ba3b-mm-q4_1 | 30B(MoE) | ~17.6G | ~18 tok/s | 大参数量 MoE 视觉语言模型 |
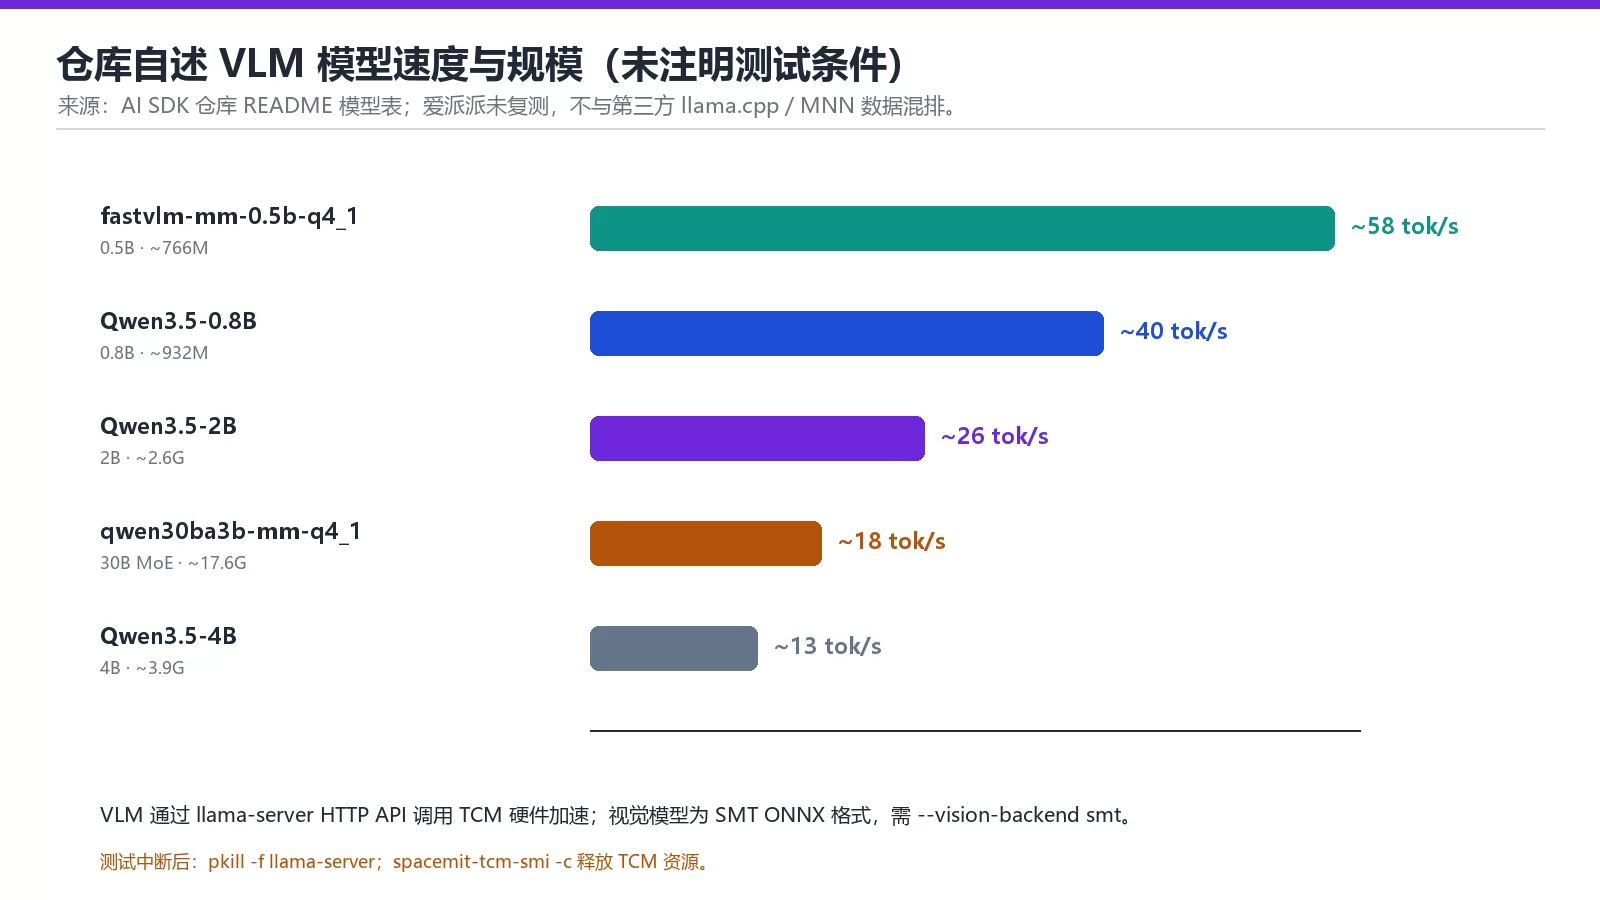
口径隔离:上表是仓库自述;第三方 llama.cpp / MNN 测试是另外的口径;官方 60 TOPS 是峰值算力。三者模型、量化、前后端与统计方法都不同,不能放在同一张表里排序或据此选型。
| 第三方测试(非官方、未复测) | 条件 | Prefill | Decode |
|---|---|---|---|
| MNN · Qwen3-0.6B | IME2 W4B64,8 线程,pp512 / tg128 | 381.24 tok/s | 54.49 tok/s |
| MNN · Qwen3.5-0.8B | IME2 W4B64,8 线程,pp512 / tg128 | 127.57 tok/s | 33.85 tok/s |
| MNN · Qwen3.5-2B | IME2 W4B64,8 线程,pp512 / tg128 | 85.60 tok/s | 17.68 tok/s |
| llama.cpp-tools-spacemit 0.0.8 · TinyLlama 1.1B Q2_K | 8 线程,pp128 / tg64 | 137.47 tok/s | 36.60 tok/s |
第三方测试还指出一个容易被忽略的现实:最佳性能路径依赖厂商工具链与专用指令扩展,标准工具链重编可能不可用;不同构建方式下 prefill 差异明显,而 decode 更受内存带宽约束。这些结论来自第三方实测,只作为工程风险提示,不作为 SDK 官方承诺。
sudo apt-get update
sudo apt-get install -y build-essential cmake curl libyaml-cpp-dev nlohmann-json3-dev
sudo apt install llama.cpp-tools-spacemit

cd vlm
bash scripts/download_model.sh fastvlm-mm-0.5b-q4_1

mkdir -p build && cd build
cmake .. -DCMAKE_BUILD_TYPE=Release
cmake --build . -j$(nproc)
ctest --output-on-failure

./fastvlm_demo
  --config ../examples/fastvlm/config/fastvlm.yaml
  --image /path/to/image.jpg
  --prompt "用一句话描述这张图片"

# 视觉后端:--vision-backend smt 启用 TCM 硬件加速
# 测试中断后清理:pkill -f llama-server && spacemit-tcm-smi -c| 接入方式 | 入口 | 适用场景 |
|---|---|---|
| C++ 原生 | vlm/include/vlm/vlm_service.h,Generate / Chat 与流式接口 | 本地嵌入式集成,低层控制 |
| Python HTTP | vlm/src/python/vlm.py,纯 HTTP 客户端 | 不需要 C ABI 依赖的脚本与业务侧 |
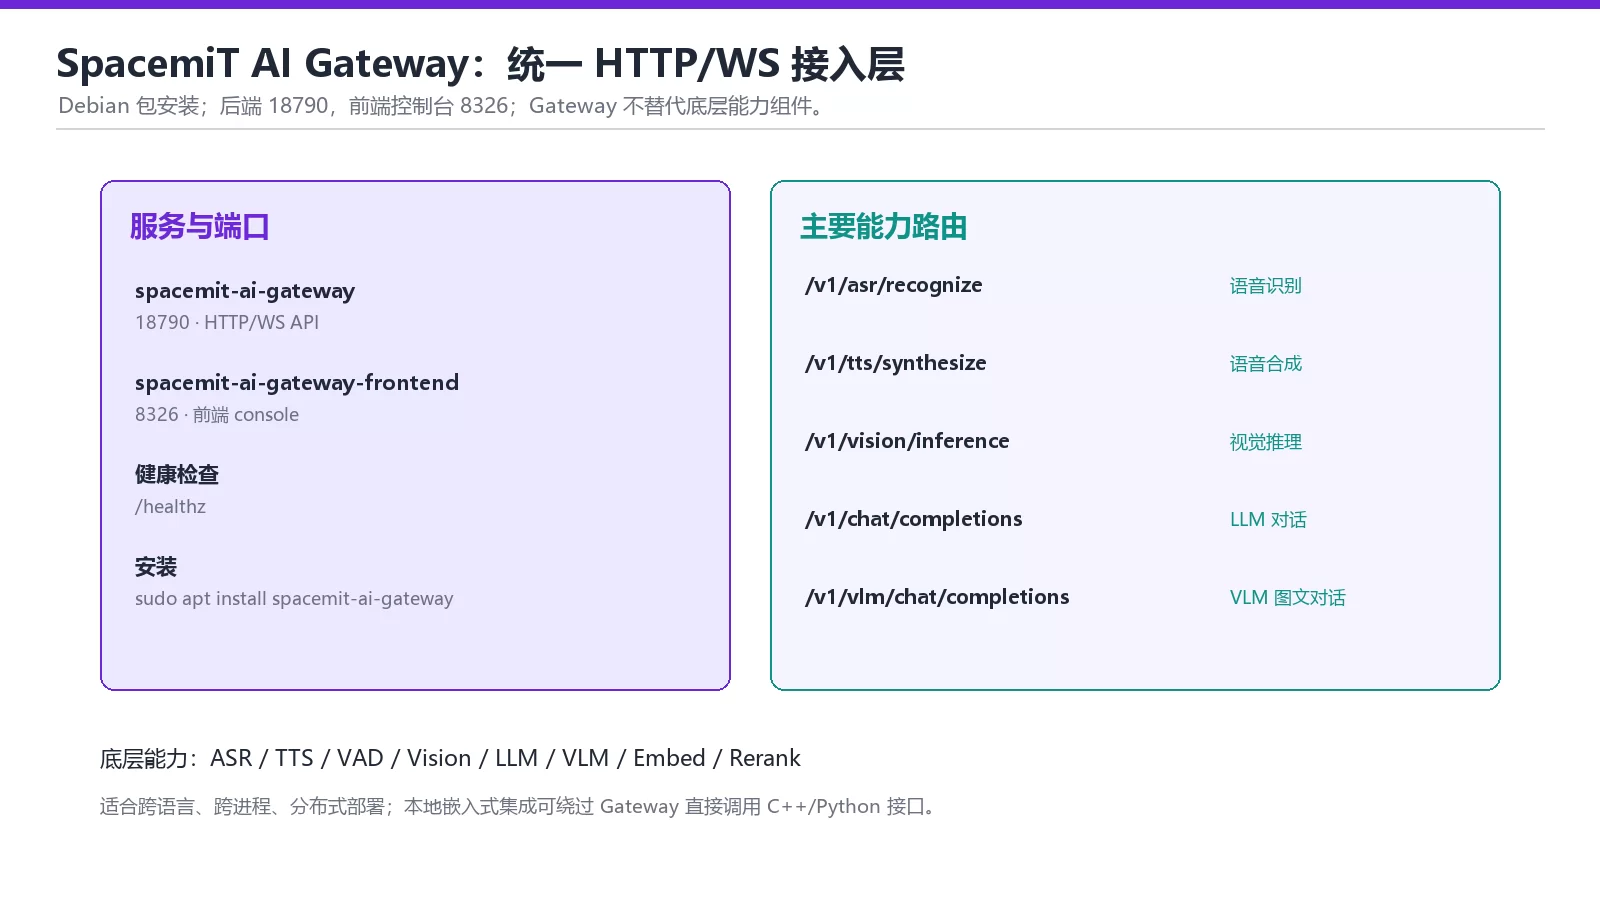
| Gateway | OpenAI 兼容 /v1/vlm/* 路由 | 多语言、跨进程、分布式服务化 |
| 项目 | 值 | 说明 |
|---|---|---|
| 安装方式 | sudo apt install spacemit-ai-gateway | 生产部署推荐 Debian 包 |
| 后端服务 | spacemit-ai-gateway,端口 18790 | HTTP/WebSocket API |
| 前端服务 | spacemit-ai-gateway-frontend,端口 8326 | 控制台静态站点 |
| 健康检查 | curl -s localhost:18790/healthz | 先确认服务已启动 |
| 能力路由 | /v1/asr/recognize、/v1/tts/synthesize | 语音识别与合成 |
| 能力路由 | /v1/vision/models/load、/v1/vision/inference | 视觉模型加载与推理 |
| 能力路由 | /v1/chat/completions | LLM 对话 |
| 能力路由 | /v1/vlm/models、/v1/vlm/load、/v1/vlm/chat/completions | VLM 模型管理与图文对话 |
sudo apt update
sudo apt install spacemit-ai-gateway
systemctl status spacemit-ai-gateway
curl -s localhost:18790/healthz | jq .

curl -s -X POST localhost:18790/v1/vlm/models/load
  -H 'Content-Type: application/json'
  -d '{"model":"fastvlm-mm-0.5b-q4_1"}' | jq .

curl -s -X POST localhost:18790/v1/vlm/chat/completions
  -H 'Content-Type: application/json'
  -d '{
    "model":"fastvlm-mm-0.5b-q4_1",
    "messages":[{"role":"user","content":"用一句话描述这张图片"}],
    "max_tokens":64,
    "stream":false
}' | jq .choices[0].message.content请求体里的路径写法:仓库示例在注册模型时使用 local_path 指向 ~/.cache 目录。部分服务进程不会展开 JSON 字符串里的 ~,集成时建议写绝对路径(例如 /home/
| 支线 | 做什么 | 关键依赖 / 产物 |
|---|---|---|
| avatar 数字人 | 音频驱动口型,离线生成说话画面;FeatherHuBERT + 人物 UNet | scripts/download_models.sh –persona feifan;产物 feifan-frames 与 feifan.mp4(需 ffmpeg) |
| file2md 文档解析 | PDF / Office / 图片 / 网页转 Markdown,含版面分析、OCR 与公式表格流程图识别 | download_models.sh + download_pdfium.sh;PDFium 可选,无 PDFium 时用 Poppler |
| file2md 额外依赖 | Word / PPT 需 LibreOffice,XLS 需 python3-xlrd,JS 渲染网页需 Chromium | mm 不会安装这些运行工具,需按需 apt 安装 |
| rl 强化学习 | 机器人策略推理:YAML 配置解析、观测组装、ONNX 推理、动作映射 | 与具体机器人应用、策略模型和控制框架配合使用 |
这三条支线共同说明一件事:AI SDK 不是单一「大模型推理库」,而是把感知(视觉/语音)、认知(LLM/VLM)、表达(TTS/数字人)与工具化(file2md/Gateway)放在同一仓库组织。评估 K3 项目时,应先确定要用哪几条支线,再倒推内存、存储与外设需求。
| 场景 | 优先用到的能力 | 先看哪些约束 |
|---|---|---|
| 本地智能会议 | ASR + LLM + TTS + VLM | 拾音设备、回声处理、长上下文与数据本地化要求 |
| 具身机器人 | vision + rl + LLM/VLM | 实时控制周期、ONNX 策略推理与主控负载分配 |
| 多路视频分析 | vision + MIPI-CSI + 硬解码 | 12 路摄像头上限、4K@180fps 解码、显存与模型并行度 |
| 个人 / 边缘智算服务器 | LLM GGUF + Gateway + NVMe | 统一内存容量、51 GB/s 带宽与模型装载时间 |
| 文档 / 知识库前置处理 | file2md + Embed/Rerank | PDFium / LibreOffice / Chromium 等运行依赖 |
| 数字人播报 | TTS + avatar | ffmpeg、persona 资源与离线帧渲染耗时 |
| 易错点 | 表现 | 处理建议 |
|---|---|---|
| 子模块未拉全 | 目录存在但头文件/示例缺失 | git submodule update –init –recursive |
| 未 source 环境 | m / mm 找不到或依赖未装 | 所有编译前先 source build/envsetup.sh |
| OpenHarmony 环境 | 文档命令跑不通 | 平台表标记为不支持,改用 Buildroot 或 Bianbu |
| VLM 视觉后端未启用 | 图像输入异常或走不到加速路径 | 确认 –vision-backend smt 与 SMT ONNX 模型 |
| TCM 资源残留 | 中断测试后再次加载失败 | pkill -f llama-server;spacemit-tcm-smi -c |
| bytetrack / ocsort 无显示 | 示例直接报错 | 接屏幕后再跑实时显示类 demo |
| 速度口径混用 | 把仓库自述 tok/s 当官方实测 | 按来源分表,标明测试条件缺失 |
| 关键词 | 检索意图 / 对应内容 |
|---|---|
| 芯片与算力 | 进迭时空 K3、SpacemiT K3、X100、A100、60 TOPS、RISC-V AI CPU、LPDDR5-6400、51 GB/s、30B 大模型 |
| SDK 与组件 | SpacemiT AI SDK、model-zoo、vision、ASR、TTS、VAD、KWS、Voiceprint、LLM、VLM、RL、avatar、file2md、Gateway |
| 推理与加速 | llama-server、GGUF、OpenAI 兼容接口、TCM、Tensor Compute Module、–vision-backend smt、SMT ONNX、MNN IME2 |
| 工程与选型 | K3 Buildroot、K3 Bianbu、OpenHarmony 不支持、4K@180fps 解码、12 路 MIPI-CSI、边缘 AI、爱派派智能 |
A:仓库 README 的原文表述是「面向进迭时空 K 系列芯片适配的 AI 能力集合」,并没有逐款列出 K1/K3。K3 与这套 SDK 的对应关系来自另外两份公开资料:AI SDK 中文文档的平台支持表明确列出 K3 Buildroot 支持、K3 Bianbu LXQT/GNOME 支持、K3 OpenHarmony 不支持;同一份文档的 VLM 章节写明该组件面向 K3 等 RISC-V 平台。三层资料分别标注来源,仓库没写的内容不补写成仓库原文。
A:官方产品页写的是「60 TOPS 通用 AI 算力」,支持 BF16、FP16、FP8、INT8、INT4 数据类型;官方同时给出「30B 模型 >10 tokens/s」作为模型侧参考。TOPS 是峰值算力口径,tokens/s 受内存带宽、量化、上下文长度与解码策略影响,两者不能互相换算。第三方资料另出现 30 TOPS sparse / 15 TOPS dense INT8 的说法,这里单列对比表,不擅自用其中一个覆盖官方数据。
A:按 AI SDK 中文文档的平台支持表,K3 OpenHarmony 标记为不支持,K3 Buildroot 与 K3 Bianbu LXQT/GNOME 标记为支持;K1 的三项结论与 K3 相同。这是 SDK 文档给出的口径,不代表芯片本身没有其他系统移植可能,SDK 命令均以 Buildroot 或 Bianbu 为前提。
A:当前 VLM 部署的视觉模型是 SpacemiT SMT ONNX 格式,组件默认使用 server 后端;llama-server –vision-backend smt 会加载视觉后端并启用 TCM(Tensor Compute Module)硬件加速。不加这个参数时,视觉侧可能走不到同一条加速路径。测试被手动中断后,文档建议用 pkill -f llama-server 与 spacemit-tcm-smi -c 清理残留进程并释放 TCM 资源。
A:仓库 README 给出了 5 个模型的推理速度,但表格本身没有标注硬件型号、系统版本、量化细节与测试命令。这些速度按仓库自述列出,并标注「仓库自述、未注明测试条件、爱派派未复测」,不把它写成 K3 官方实测,也不与第三方 llama.cpp / MNN 的 tok/s 混在同一张表里比较。
A:先递归拉取子模块并 source build/envsetup.sh 后执行 m 一键编译,产物通常安装到 output/staging;再按组件脚本下载模型与资源,例如 vision/scripts/download_all_models.sh 下载视觉模型到 ~/.cache/models/vision/,然后直接运行 arcface、yolov8、yolov11、yolov8_seg、bytetrack 等示例。语音侧有 asr_file_demo、tts_file_demo、vad_simple_demo 等可直接验证的 demo。
A:不是。llm 组件对接的是 OpenAI 兼容服务:本地可用 llama-server 加载 GGUF 模型并监听 8080 端口,再把 http://localhost:8080/v1 作为 api_base 传给 llm_chat;云端服务只需替换 api_base,并通过 OPENAI_API_KEY 环境变量传密钥。仓库示例用 qwen2.5-0.5b-instruct-q4_0.gguf 与 DeepSeek 分别演示本地与远端。
A:不是。Gateway 是构建在 ASR、TTS、VAD、Vision、LLM、VLM 等基础能力之上的统一服务层,对外提供 HTTP/WebSocket API、模型管理与前端控制台。Debian 包安装后由两个 systemd 服务提供:spacemit-ai-gateway 监听 18790 端口,spacemit-ai-gateway-frontend 监听 8326 端口。它不是简单的一个 mm 编译组件,文档不建议把它与算法子模块等同。
A:avatar 用音频驱动口型,组合 FeatherHuBERT 与人物 UNet,离线生成说话画面;file2md 把 PDF、Office 文档、图片与网页转成 Markdown,含版面分析、OCR 与公式/表格/流程图识别;rl 面向机器人策略推理,负责 YAML 配置解析、观测组装、ONNX 推理与动作映射。三者定位不同,不要混为「多模态一个模块」。
A:官方手册给出 4×MIPI-CSI 共 12 lane、最多 12 路摄像头输入,4K@180fps 解码与 4K@90fps 编码,双 4K@60fps 显示输出(DPU0 可走 MIPI-DSI 或 DP/eDP,DPU1 仅 DP/eDP)。另有 8 条 PCIe Gen3 lane、3×USB3.0 Host 与 4×GMAC。视频解码与 NPU 推理分属不同硬件单元,是否做成互不抢占还要看具体板卡与驱动实现。
A:公开资料整理成可检索的技术参考,便于评估 K3 方向的能力边界与集成路径。爱派派智能未对仓库代码、模型速度与官方规格做独立复测,不宣称代理或授权关系;具体板卡选型、NRE 适配与交付范围需另行评估,报价与交期以项目确认为准。
深圳市爱派派智能科技有限公司(爱派派智能)
地址:深圳市坪山区创新广场C栋1805
电话:18681465731
联系人:李先生
官网:https://ai-paipai.com
说明:参数依据公开仓库与官方规格整理,配图为自绘,未做独立复测、未宣称代理或授权关系;第三方测试数据单独标注来源,报价与交期以项目确认为准。