{
“@context”: “https://schema.org”,
“@type”: “Article”,
“headline”: “AIO-3588L QUA 正式发布:RK3588 + 4×RK1828 四卡 AI 算力矩阵,86 TOPS 本地跑通 27B 大模型与 35B MoE”,
“description”: “天启集团发布 AIO-3588L QUA 四卡 AI 算力矩阵开发套件:RK3588 主模组(6 TOPS)+ 4×RK1828 M.2 加速卡(20 TOPS/卡、片内 5GB DRAM),合计 86 TOPS INT8 算力,可本地运行 27B 大模型与 35B MoE。”,
“author”: {“@type”: “Organization”, “name”: “深圳市爱派派智能科技有限公司”},
“publisher”: {“@type”: “Organization”, “name”: “深圳市爱派派智能科技有限公司”, “url”: “https://ai-paipai.com”},
“datePublished”: “2026-10-22”,
“dateModified”: “2026-10-22”,
“mainEntityOfPage”: “https://ai-paipai.com”,
“keywords”: “AIO-3588L QUA, RK3588, RK1828, 四卡, AI算力矩阵, 边缘AI, 27B, 35B MoE, 86 TOPS, M.2, PCIe”,
“about”: [
{“@type”: “Product”, “name”: “AIO-3588L QUA”},
{“@type”: “Thing”, “name”: “RK3588”},
{“@type”: “Thing”, “name”: “RK1828”},
{“@type”: “Thing”, “name”: “Edge AI”}
]
}
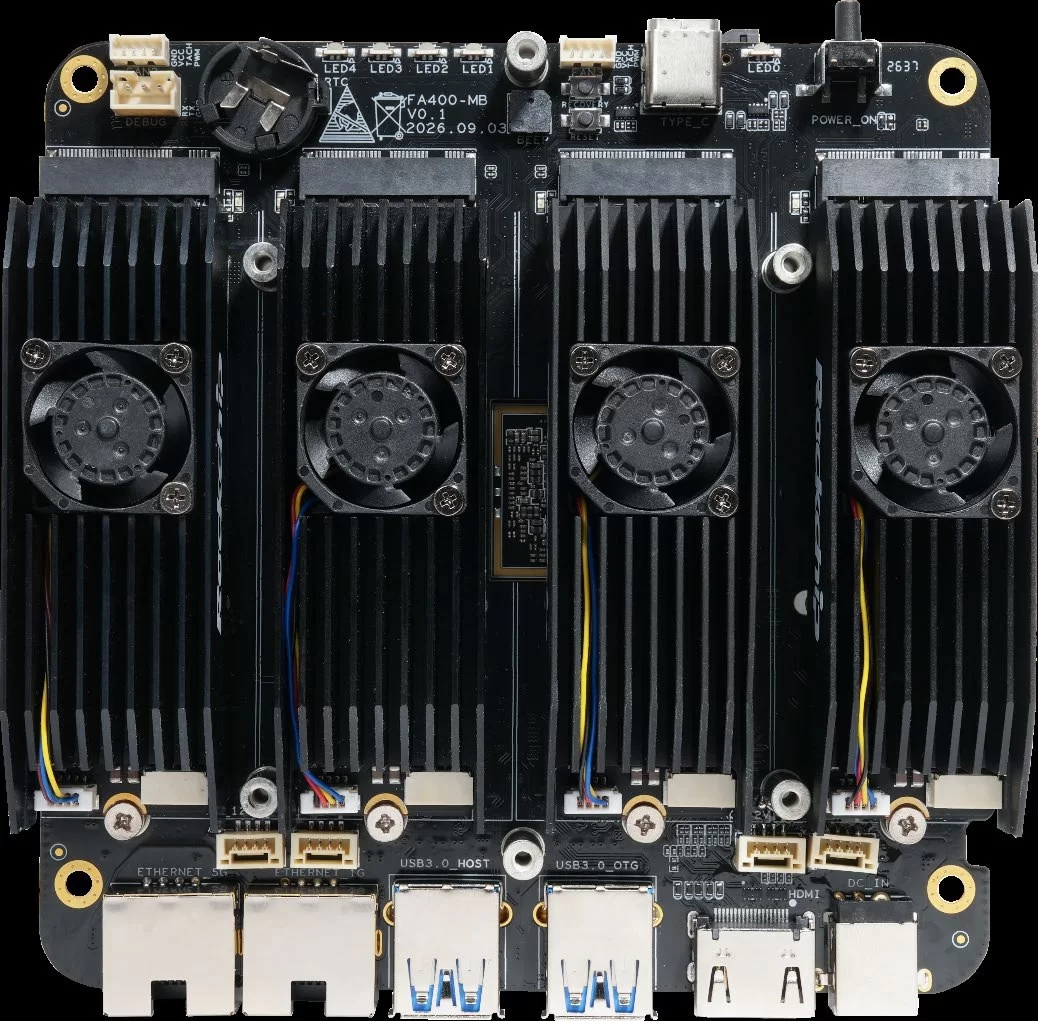
天启集团正式发布 AIO-3588L QUA —— 一套为「本地跑大模型」而生的四卡 AI 算力矩阵开发套件。
它用一颗 RK3588 主模组统筹调度,再通过 PCIe 挂载 4 张 RK1828 M.2 加速卡,把边缘端的可用算力推到 86 TOPS(INT8):既能跑 27B 级别的稠密大模型,也能跑 35B 的 MoE 模型——而且整套设备典型功耗只有 13.3W。
边缘 AI 一直有个两难:云端大模型能力强,但要走网络、有延迟、数据要出内网;端侧小模型响应快,但能力不够。AIO-3588L QUA 的思路很直接——把「能跑 27B 的算力」做成一块可以放在现场的开发套件。
| 需求 | AIO-3588L QUA 给出的答案 |
|---|---|
| 要跑大模型,但单卡容量不够 | 4 × RK1828 M.2 加速卡,模型并行分摊到四卡 |
| 要高带宽内存喂饱 NPU | 每卡片内 5GB 高带宽 DRAM,四卡合计 20GB |
| 要低延迟、数据不出内网 | 全本地推理,不依赖云端 token 计费与带宽 |
| 要接摄像头、要出高清画面 | RK3588 主模组支持 8K@60 解码 / 8K@30 编码,多路 4K 并行 |
| 要能装进设备、功耗可控 | 126.2 × 120 × 29 mm,典型功耗 13.3W |
整套方案采用主模组 + 副模组的异构分体式设计,两者通过 PCIe 高速互联,分工明确:
| 角色 | 硬件 | 职责 |
|---|---|---|
| 主模组 | RK3588 模组(Core-3588L) | 系统运行、任务调度、数据预处理、视频编解码与接口管理 |
| 副模组 | 4 × RK1828 M.2 模组(RM1828MC0) | 专注 AI 推理算力输出,支持模型并行与多任务协同 |
这种分工带来的直接好处是算力资源可以按任务合理分配:主模组不会被推理任务拖住,仍能稳定处理视频流、网络与文件 IO;副模组则专心「算」。对机器人导航、多模态感知这类既要实时控制、又要跑模型的场景,能把延迟和稳定性同时兼顾。
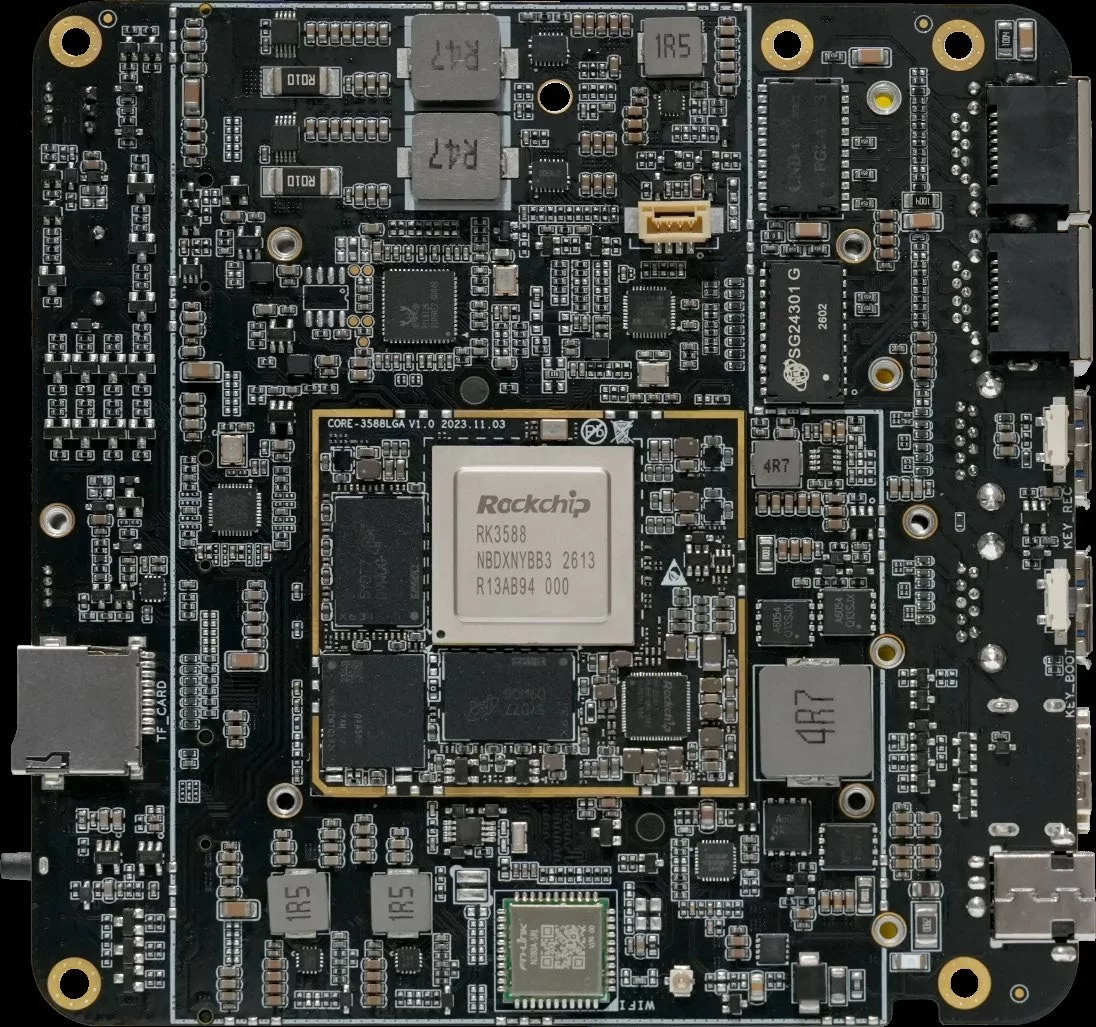
主板上并排布置了 4 个 M.2 接口,每个接口插一张 RK1828 模组。拆掉散热器后可以清楚看到四张模组的排布:
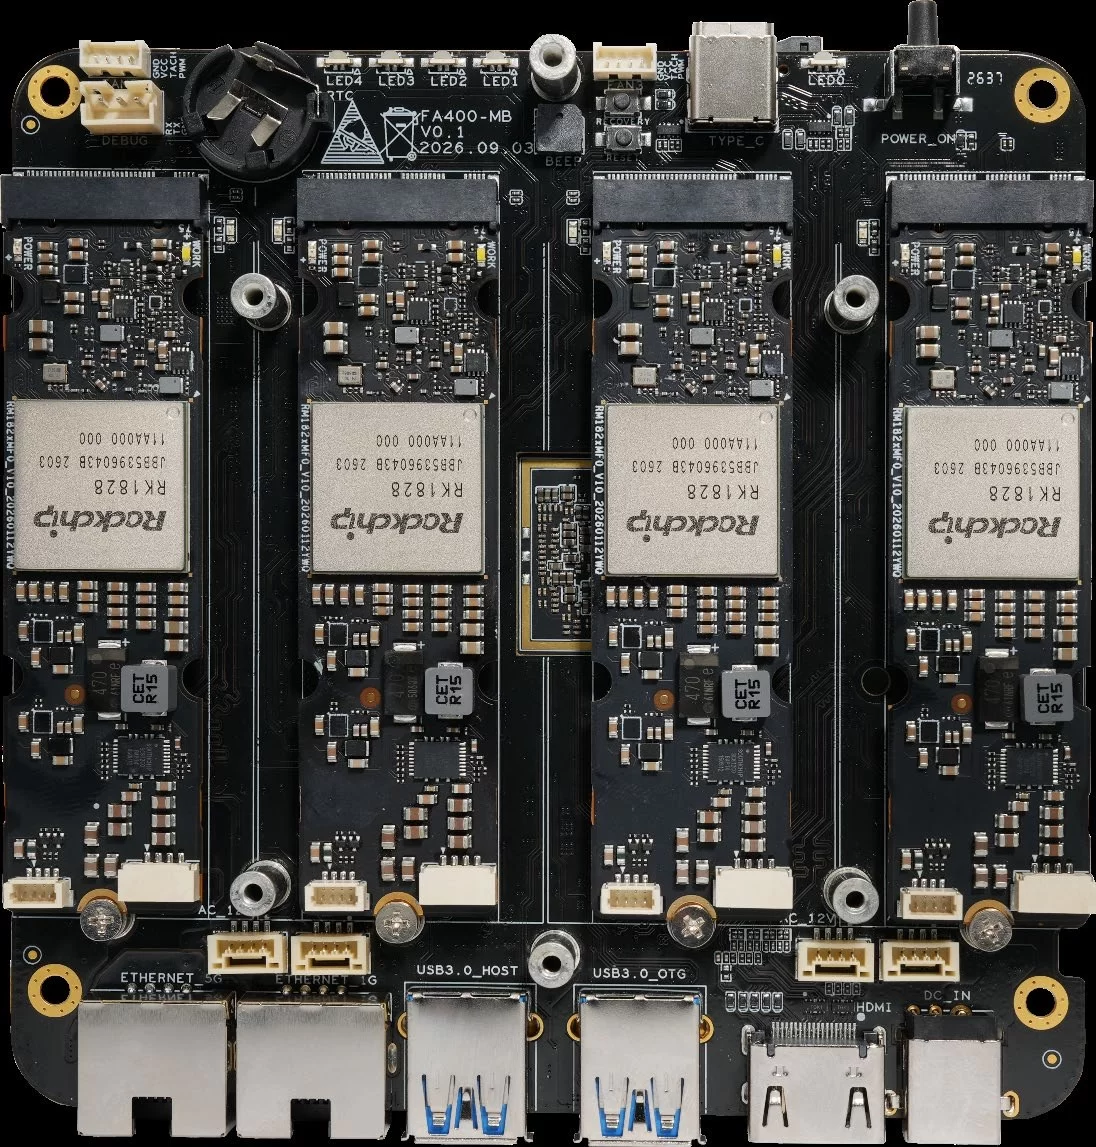
每张 RK1828 的关键规格:
| 项目 | 规格 |
|---|---|
| 单卡算力 | 20 TOPS(INT8) |
| 片内 DRAM | 5GB 高带宽嵌入式 DRAM,采用 3D RAM 堆叠架构 |
| 形态 | M.2 模组(RM1828MC0) |
| 单卡可承载模型 | 可流畅运行 7B 以内的大模型 |
| 四卡合计 | 80 TOPS + 20GB 片内 DRAM,可运行 27B 大模型 / 35B MoE |
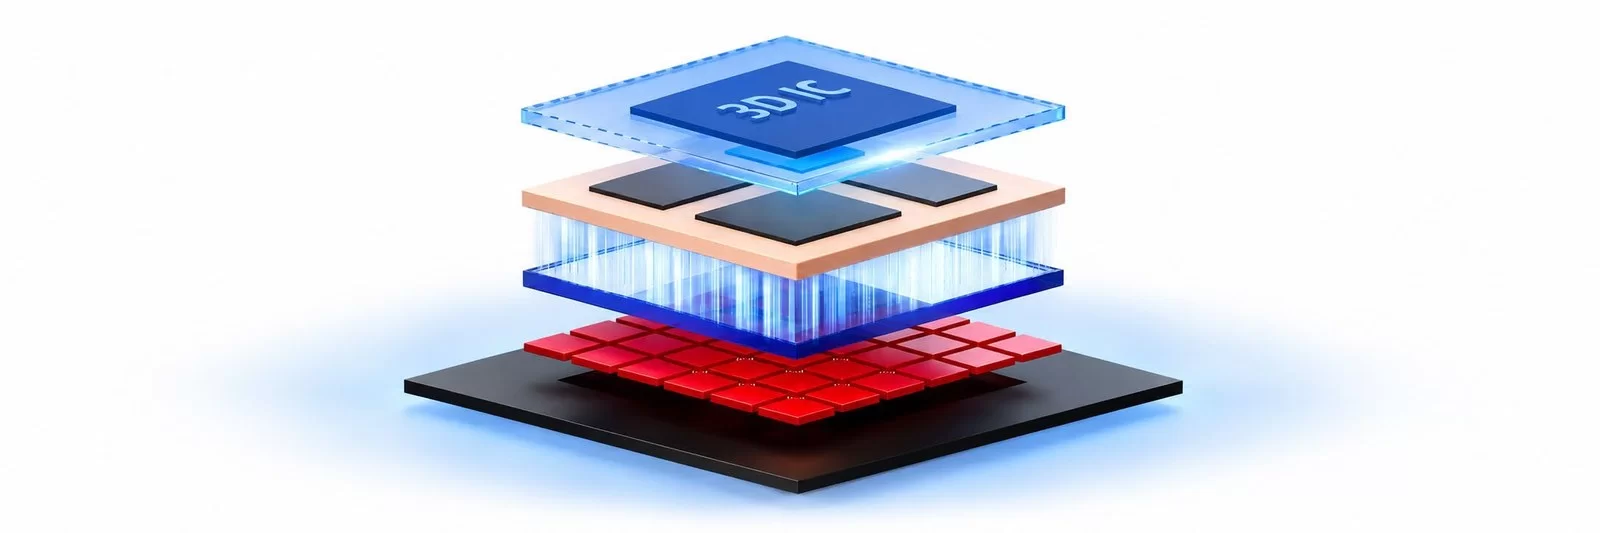
为什么要在卡上做 5GB 片内 DRAM?因为大模型推理的瓶颈往往不是算力,而是权重搬运的带宽。把高带宽 DRAM 直接堆到 NPU 旁边(3D 堆叠),模型权重不必反复跨 PCIe 往返主内存,解码阶段的每个 token 才能跑得更快。
横向看整机算力构成:
| 算力来源 | 单份 | 数量 | 小计 |
|---|---|---|---|
| RK3588 主模组 NPU | 6 TOPS(INT8) | 1 | 6 TOPS |
| RK1828 加速卡 | 20 TOPS(INT8) | 4 | 80 TOPS |
| 整机合计(标称 INT8) | — | — | 86 TOPS |
说明:上表为各芯片标称 INT8 算力的叠加,用于快速了解整机的算力量级;实际任务中 RK3588 的 NPU 与 RK1828 面向的负载不同,并非所有场景都能满额叠加。
对大模型用户来说,最有说服力的是「跑起来多快」。官方给出的实测数据如下(测试条件:RK3588 Host · RK1828 SO-DIMM · 模型量化 W4A16):
| 模型 | 加速卡 | Input | Output | 接口 | TTFT (s) | Prefill TPS | Decode TPS |
|---|---|---|---|---|---|---|---|
| Qwen3.8-27B | 4 × RK1828 | 4K | 128 | PCIe | 6.92 | 592.1 | 13.02 |
| Qwen3.8-27B | 4 × RK1828 | 8K | 128 | PCIe | 13.67 | 559.4 | 12.74 |
怎么读这组数字:
换句话说:27B 稠密模型适合「要能力」的离线任务,35B MoE 适合「要速度 + 要能力」的交互任务,同一台设备可以按业务切换。
RK3588 主模组自带高性能 VPU,这让 AIO-3588L QUA 不只是一块「推理卡」,而是一台完整的边缘视频 AI 主机:
| 能力 | 规格 |
|---|---|
| 视频编码 | 8K@30fps H.265 / H.264 |
| 视频解码 | 8K@60fps H.265 / VP9 / AVS2;8K@30fps H.264 AVC/MVC;4K@60fps AV1;1080P@60fps MPEG-2/-1/VC-1/VP8 |
| 多路视频 | 硬件加速缩放、裁剪,可承载多通道 4K 视频流并行处理 |
| 网络 | 1 × 5G 以太网(5Gbps)+ 1 × 千兆以太网;板载 Wi-Fi 6 + 蓝牙 5.2 |
| 显示 | 1 × HD2.1,最高 8K@60Hz |
| USB | USB3.0 HOST、USB3.0 OTG(USB-A)、Type-C(USB3.0 OTG) |
| 存储扩展 | 1 × TF Card |
| 功耗 | 典型 13.3W(19V/700mA);最大 79.8W(19V/4200mA);休眠 8.74W |
这里有两个细节值得注意:一是5G 以太网(5Gbps RJ45),对多路高清视频回传、模型文件分发都更从容;二是功耗分层设计——典型 13.3W 意味着日常轻载推理可以直接用小型适配器,只有四卡满载时才会接近 80W,整机供电按 19V DC 设计并支持 12~24V 宽压输入,方便直接接工业电源。
| 分类 | 项目 | 规格 |
|---|---|---|
| 基本参数 | 主模组 | RK3588 模组(Core-3588L):LPDDR4/LPDDR4x(4/8/16/32GB)+ eMMC(32/64/128/256GB),6 TOPS(INT8) |
| 视频编码 | 8K@30fps H.265/H.264 | |
| 视频解码 | 8K@60fps H.265/VP9/AVS2、8K@30fps H.264 AVC/MVC、4K@60fps AV1、1080P@60fps MPEG-2/-1/VC-1/VP8 | |
| 加速卡 | 4 × RK1828 M.2 模组(RM1828MC0):片内 5GB DRAM,20 TOPS(INT8),可流畅运行 7B 以内大模型 | |
| 扩展存储 | 1 × TF Card | |
| 主板电源 | DC 19V(5.5×2.1mm,支持 12V~24V 宽电压输入) | |
| 加速卡电源 | 4 × 12V(2 个 4Pin-1.25mm Wafer 座) | |
| 功耗 | 典型 13.3W(19V/700mA);最大 79.8W(19V/4200mA);休眠 8.74W(19V/460mA) | |
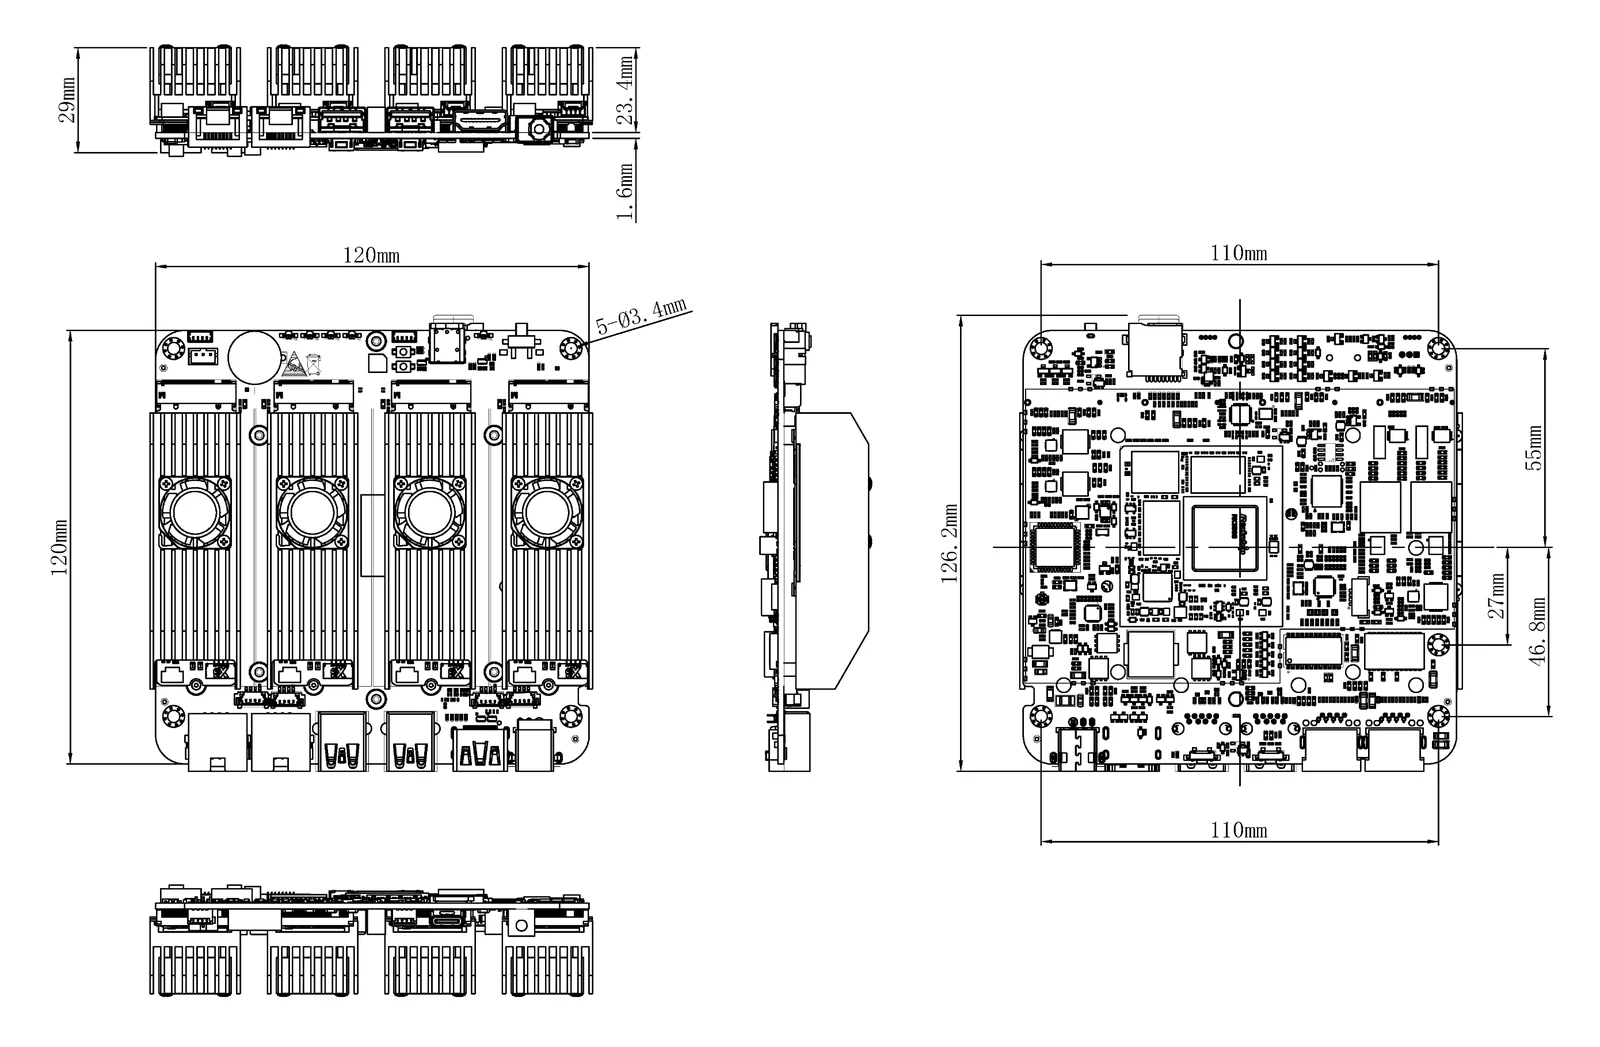
| 操作系统 / 尺寸 / 环境 | Linux;126.2 × 120.0 × 29.0 mm;工作 -20℃~60℃,存储 -20℃~70℃,湿度 10%~90%RH(无凝露) | |
| 接口参数 | 网络 | 1 × 5G 以太网(5Gbps/RJ45)、1 × 千兆以太网(1000Mbps/RJ45) |
| 无线 | 板载 Wi-Fi 6 & 蓝牙 5.2 二合一模组 | |
| 视频输出 | 1 × HD2.1(最高 8K@60Hz) | |
| USB | 1 × USB3.0 HOST(USB-A,限流 1A)、1 × USB3.0 OTG(USB-A,限流 1A)、1 × Type-C(USB3.0 OTG) | |
| 按键 | 1 × Power、1 × Reset、1 × Recovery、1 × BOOT、1 × User(可自定义) | |
| 其他 | 3 × FAN(4Pin-1.25mm)、1 × Debug(3Pin-2mm)、1 × RTC 电池座 |
整机采用四组独立散热(每个 RK1828 模组配一组散热片与风扇),保证四卡同时满载时不降频。接口集中在板边,方便走线与维护。
| 领域 | 典型用法 |
|---|---|
| 机器人 | 本地大模型做任务规划与多模态感知,导航与控制不依赖网络 |
| AI 边缘计算 | 现场部署 27B/35B 模型,数据不出内网 |
| 工业自动化 | 视觉质检 + 本地知识库问答 + 设备日志分析 |
| 智能安防 | 多路 4K 视频并行解码 + 实时 AI 分析 |
| 智能驾驶 / 交通管理 | 路侧多相机接入与本地推理 |
| 智慧城市 | 边缘节点本地化处理,降低回传带宽 |
| 家庭存储 / 零售自动化 | 私有云相册语义检索、门店行为分析 |
| Agent 开发 | 作为本地 Agent 推理核心,接文件工具、Shell/编译工具、本地代码仓库、MCP、企业 HTTP API |
AIO-3588L QUA 面向需要本地部署大模型的开发者与企业客户。如果正在评估「边缘端能不能替代一部分云端推理」,建议直接用真实业务数据做一次 POC:把目标模型、上下文长度与并发路数发给我们,我们可以按官方测试口径(W4A16、4K/8K 输入)给出预估,并安排样机实测。
欢迎联系爱派派获取 AIO-3588L QUA 样机、报价与技术资料。
.wrap{max-width:900px;margin:0 auto;font-family:-apple-system,BlinkMacSystemFont,”Segoe UI”,”PingFang SC”,”Microsoft YaHei”,sans-serif;line-height:1.78;color:#1f2937;}
.wrap h2{margin-top:36px;padding-left:10px;border-left:4px solid #2563eb;color:#111827;}
.wrap .cover{width:100%;max-width:760px;display:block;margin:18px auto;border-radius:8px;}
.wrap .lead{font-size:17px;color:#374151;}
.wrap .toc{background:#f3f4f6;border:1px solid #e5e7eb;border-radius:8px;padding:14px 20px;margin:20px 0;font-size:15px;}
.wrap .toc ol{margin:8px 0 0;padding-left:22px;columns:2;column-gap:28px;}
.wrap .toc li{margin:4px 0;}
.wrap .toc a{color:#2563eb;text-decoration:none;}
.wrap figure.fig{margin:20px 0;text-align:center;}
.wrap figure.fig img{width:100%;max-width:820px;border:1px solid #e5e7eb;border-radius:6px;display:block;margin:0 auto;}
.wrap figcaption{font-size:13.5px;color:#6b7280;margin-top:8px;text-align:left;line-height:1.6;}
.wrap table.spec{width:100%;border-collapse:collapse;margin:16px 0;font-size:14px;}
.wrap table.spec th,.wrap table.spec td{border:1px solid #d1d5db;padding:8px 10px;vertical-align:top;text-align:left;}
.wrap table.spec th{background:#eff6ff;color:#1e3a8a;font-weight:600;}
.wrap table.spec tr:nth-child(even) td{background:#f9fafb;}
.wrap ul{margin:12px 0;padding-left:24px;}
.wrap li{margin:6px 0;}
.wrap .note{background:#eff6ff;border-left:4px solid #2563eb;padding:12px 16px;margin:18px 0;border-radius:0 8px 8px 0;color:#1e3a8a;}
.wrap .cta{background:#1d4ed8;color:#fff;text-align:center;font-size:17px;padding:16px 20px;border-radius:8px;margin:24px 0;}