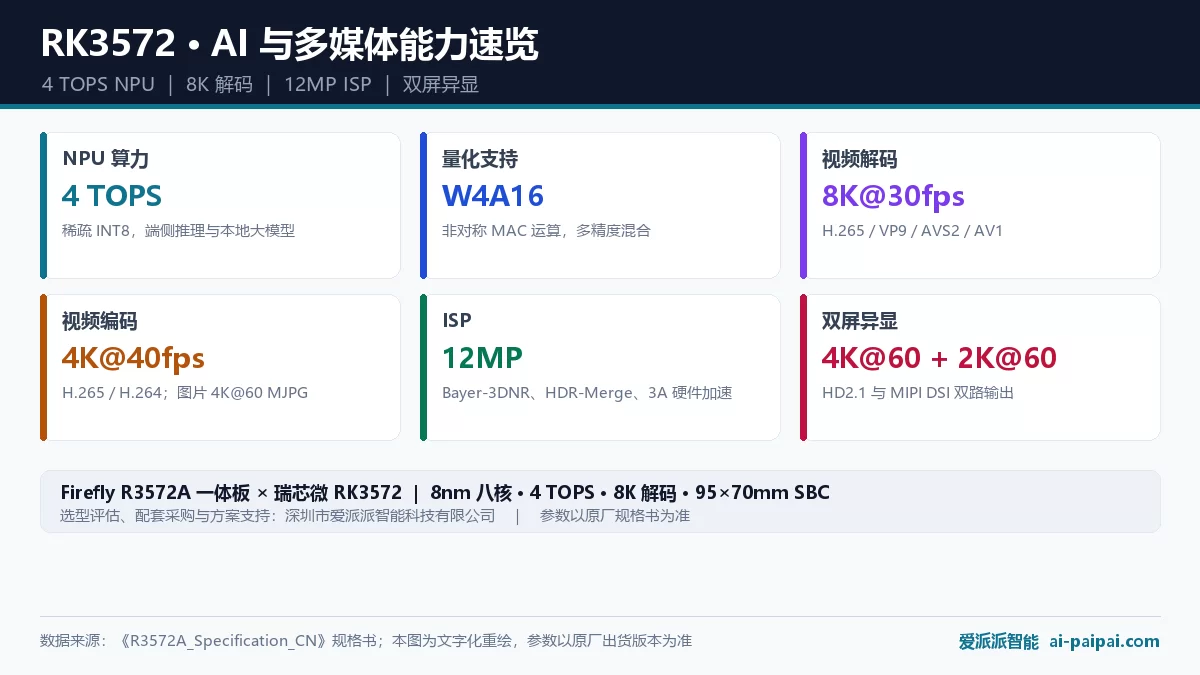
4 TOPS 稀疏 INT8、W4A16 端侧大模型、8K@30fps 解码、12MP ISP 与双屏异显。
RK3572 把 NPU、编解码、影像与图形能力集中在一颗 8nm 芯片上:支持 Gemma / ChatGLM / Qwen / Phi 系列私有化部署、YOLO 检测、RKNN 导入导出与主流框架,并给出完整的视频编解码与 ISP 硬件算法清单。
依据《R3572A_Specification_CN》规格书的产品特点、基本参数与软件支持章节,把 NPU 精度、大模型与框架、编解码格式、ISP 算法、GPU API 与显示能力逐项转为文本表格。规格书未给出的参数量、上下文长度、实测 TPS 与多路并发路数,均标注为未标注,不做推断。
深圳市爱派派智能科技有限公司(爱派派智能)可提供该平台的选型评估、配套采购与方案对接支持。规格书中的模型系列名称为能力描述,不代表具体模型可跑或性能承诺;落地前请索取目标模型的 RKNN 产物与实测报告。
RK3572 的 AI 能力集中在一条规格上:4 TOPS(稀疏 INT8)。这个数字后面跟着一长串精度支持——INT4、INT8、INT16、FP4、FP8、FP16、BF16 混合运算,以及 W4A16 非对称 MAC 运算。对端侧设备而言,重点不是峰值数字,而是能否用低位宽量化把模型装进有限内存,并在功耗预算内跑起来。
| NPU 条目 | 规格书标注 | 解读与边界 |
|---|---|---|
| 算力 | 4 TOPS(稀疏 INT8) | 标注为稀疏口径,不可与稠密 INT8 数值直接比较 |
| 整数精度 | INT4 / INT8 / INT16 | 低位宽量化有利于压缩权重与提升吞吐 |
| 浮点精度 | FP4 / FP8 / FP16 / BF16 | 覆盖混合精度推理与部分训练后量化流程 |
| 特殊运算 | W4A16 非对称 MAC 运算 | 权重 4bit、激活 16bit 的量化组合支持 |
| 模型工具 | RKNN 模型导入导出、自定义算子开发 | 便于迁移已有模型与补充算子 |
| 未标注项 | 参数量上限、上下文长度、实测 TPS | 规格书未提供,不推断 |
说明:瑞芯微官网对 RK3576 标注的是 6 TOPS(INT8),对本芯片规格书标注的是 4 TOPS(稀疏 INT8)。稀疏与稠密是不同统计口径,两者不能直接相减或当作倍数关系。跨芯片选型请见《RK3572 / RK3576 / RK3399 对比选型》。
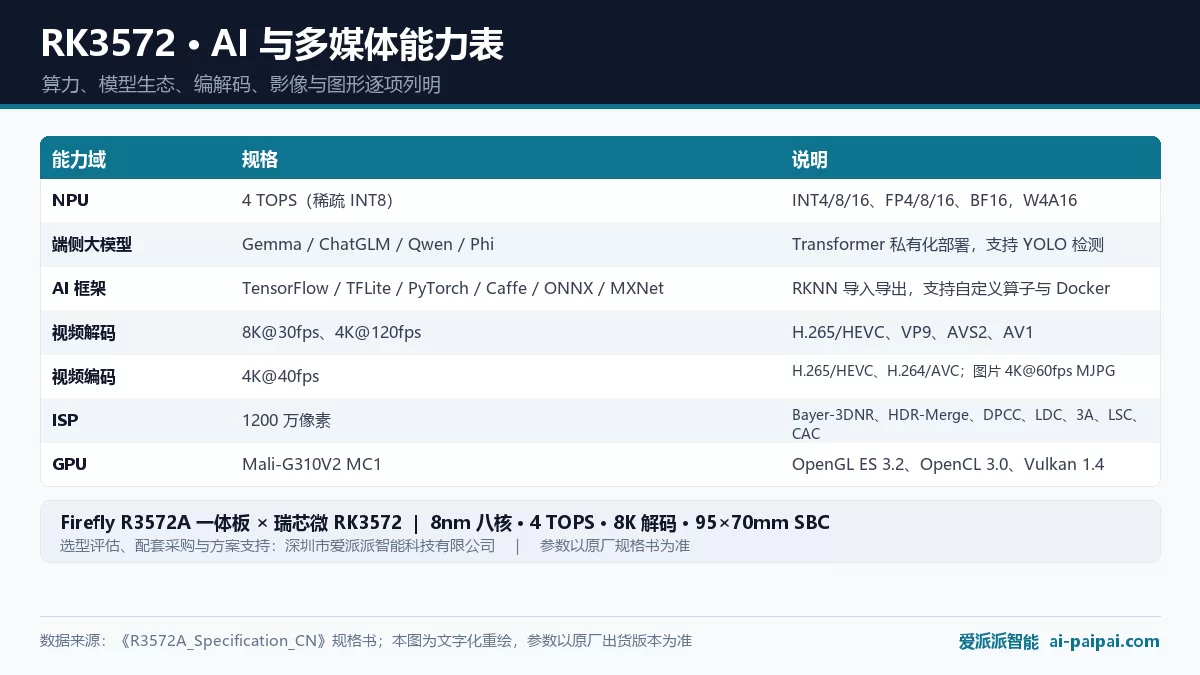
规格书在「软件支持」里给了三类能力:超大规模参数模型的私有化部署、传统网络架构与 YOLO 检测、以及完整框架与工程化工具链。下表逐条列明。
| 能力层级 | 规格书标注内容 | 工程含义 |
|---|---|---|
| 大模型 | Transformer 架构下超大规模参数模型的私有化部署:Gemma、ChatGLM、Qwen、Phi 系列 | 支持本地推理与数据不出内网,但未给出参数量与实测速度 |
| 检测 | 支持 YOLO 目标检测算法 | 常见视觉检测任务可直接落地 |
| 传统网络 | CNN、RNN、LSTM 等传统网络架构 | 覆盖分类、时序与语音类模型 |
| 模型工具 | 支持 RKNN 模型导入导出 | 与瑞芯微 AI 工具链对接 |
| 框架 | TensorFlow、TensorFlow Lite、PyTorch、Caffe、ONNX、MXNet | 主流训练框架模型可转换接入 |
| 扩展 | 支持自定义算子开发 | 非标准结构可自行补齐算子 |
| 部署 | Docker 容器化管理技术 | 便于服务化封装与版本管理 |
能力描述 ≠ 实测承诺:规格书对大模型的表述是「支持私有化部署」并列举系列名称,没有给出具体模型版本、量化方式、上下文长度或 TPS。项目评估时应索取目标模型的RKNN 产物与实测报告,而不是按系列名称推断可跑。
| 方向 | 分辨率 / 帧率 | 格式 | 备注 |
|---|---|---|---|
| 解码 | 8K@30fps | H.265/HEVC、VP9、AVS2、AV1 | 规格书产品特点与基本参数一致 |
| 解码 | 4K@120fps | H.265/HEVC、VP9、AVS2、AV1 | 高帧率解码能力 |
| 解码 | 4K@60fps | H.264/AVC | 单独列出,低于前两档帧率 |
| 编码 | 4K@40fps | H.265/HEVC、H.264/AVC | 编码帧率上限,非 60fps |
| 图片编解码 | 4K@60fps | MJPG | 图片类编解码能力 |
| 未标注 | 多路并发路数 | 未标注 | 规格书未给并发规格,需实测 |
产品特点页与规格参数页对解码能力的表述一致:8K@30fps / 4K@120fps 高帧率视频解码,以及 4K@40fps 视频编码。需要注意的是,编码档位是 40fps 而非 60fps,做录制与推流方案时不要按 60fps 规划。
| ISP 条目 | 规格书标注 | 作用 |
|---|---|---|
| 像素能力 | 内置 1200 万像素 ISP | 摄像头传感器直连与图像处理 |
| 降噪 | Bayer-3DNR | Bayer 域三维降噪 |
| 宽动态 | HDR-Merge | 多曝光合成 |
| 坏点校正 | DPCC | 坏像素检测与校正 |
| 畸变校正 | LDC | 镜头畸变矫正 |
| 自动调节 | 3A | 自动曝光 / 对焦 / 白平衡 |
| 阴影与色差 | LSC、CAC | 镜头阴影与色差补偿 |
| 增强 | 去雾增强 | 雾天与低对比场景增强 |
| 摄像头输入 | 2 × MIPI CSI DPHY(1×4Lane 或 1×2Lane) | 支持 2 路摄像头输入 |
| GPU 条目 | 规格书标注 | 对比提示 |
|---|---|---|
| 型号 | ARM Mali-G310V2 MC1 | 规格书产品特点页简写为 Mali G310 |
| OpenGL ES | 1.1 / 2.0 / 3.2 | 覆盖旧版与新版本应用 |
| OpenCL | 3.0 | 通用计算接口 |
| Vulkan | 1.4 | 较新的图形 API 版本 |
| 2D 加速 | 内嵌高性能 2D 加速硬件 | UI 合成与界面渲染卸载 |
| 对照 RK3399 | Mali-T860 MP4(OpenGL ES 3.1) | 架构与 API 代际差异明显 |
| 对照 RK3576 | Mali-G52 MC3 | 同为 8nm 平台但 GPU 型号不同 |
| 显示项 | 规格书标注 | 工程提示 |
|---|---|---|
| HD2.1 | 最高 4K@60Hz | 板卡实物丝印为 HDMI,命名差异已标注 |
| MIPI DSI | DPHY 1.2,1×4Lanes,2.5Gbps/Lane,30Pin-0.5mm | 直驱屏需核对时序与背光控制 |
| 双屏异显 | 4K@60fps + 2K@60fps | 两路不同分辨率同时输出 |
| 摄像头输入 | 2 路 MIPI CSI DPHY | 与双屏组合构成双摄双显形态 |
| 典型场景 | 数字标牌、零售双屏终端、平板 | 规格书列出的应用领域 |
| 系统 / 工具 | 规格书标注 | 适用项目 |
|---|---|---|
| Android 16 | 系统支持 | 带 UI 的终端、商显与平板类设备 |
| Linux OS | 系统支持 | 嵌入式服务、网关与工业控制 |
| RKNN | 模型导入导出 | 模型转换与部署 |
| 自定义算子 | 支持开发 | 非标准模型结构适配 |
| Docker | 容器化管理技术 | 服务化封装与多版本隔离 |
| YOLO | 目标检测算法支持 | 安防、工业检测与零售分析 |
| 常见误区 | 正确理解 | 建议动作 |
|---|---|---|
| 4 TOPS 与 6 TOPS 可直接比大小 | 稀疏 INT8 与 INT8 口径不同 | 对齐量化与测试模型后再比较 |
| 写了 Gemma / Qwen 就能跑任意大模型 | 规格书只给能力描述与系列名,无参数量承诺 | 索取目标模型 RKNN 产物与实测数据 |
| 8K@30fps 等于可同时解多路 8K | 规格书未给并发路数 | 按码率与内存带宽压测 |
| 4K 编码是 60fps | 规格书标注 4K@40fps | 录制与推流按 40fps 规划 |
| HD2.1 就是 HDMI 2.1 | 文字与板卡丝印不一致 | 向原厂核对协议版本与 HDCP |
| 12MP ISP 等于双路各 12MP | 原文未标注逐映射关系 | 查原厂 ISP 数据手册 |
| 项目任务 | 优先核对的能力 | 风险点 |
|---|---|---|
| 端侧问答 / 本地 Agent | 4 TOPS NPU、W4A16、内存 8GB~16GB、RKNN 产物 | 模型大小、上下文长度与实测 TPS |
| 视觉检测 / AI 摄像头 | 12MP ISP、2 × MIPI CSI、YOLO 支持 | 多路并发与帧率 |
| 8K 播放 / 商显 | 8K@30fps 解码、HD2.1 4K@60Hz、Vulkan 1.4 | 接口协议版本与线材 |
| 双屏零售终端 | 4K@60 + 2K@60 双屏异显、MIPI DSI | 屏时序与背光控制 |
| 多路视频分析 | 4K@120fps 解码、Docker 服务化 | 并发路数未标注,需压测 |
| 工业网关 | Linux OS、双千兆网、自定义算子 | 宽温与散热(工作 -20℃~60℃) |
下表按层级汇总所覆盖的算力、模型、编解码与影像关键词。
| 关键词层级 | 关键词 |
|---|---|
| 算力与精度 | 4 TOPS 稀疏 INT8、INT4、INT8、INT16、FP4、FP8、FP16、BF16、W4A16 非对称 MAC、混合运算 |
| 模型与框架 | Gemma、ChatGLM、Qwen、Phi、Transformer 私有化部署、YOLO、CNN、RNN、LSTM、RKNN、TensorFlow、PyTorch、ONNX、MXNet、Caffe、TensorFlow Lite、自定义算子、Docker |
| 视频编解码 | 8K@30fps、4K@120fps、4K@60fps H.264、4K@40fps 编码、4K@60fps MJPG、H.265/HEVC、VP9、AVS2、AV1、AVC |
| 影像与图形 | 1200 万像素 ISP、Bayer-3DNR、HDR-Merge、DPCC、LDC、3A、LSC、CAC、去雾增强、Mali-G310V2 MC1、Vulkan 1.4、OpenCL 3.0、OpenGL ES 3.2 |
| 显示与系统 | HD2.1 4K@60Hz、MIPI DSI 2.5Gbps/Lane、双屏异显 4K@60 + 2K@60、Android 16、Linux OS |
| 场景词 | 端侧大模型、边缘 AI 推理、AI 摄像头、智能监控、数字标牌、多路视频分析、私有化部署、数据不出内网 |
| 品牌与服务 | 爱派派智能、深圳市爱派派智能科技有限公司、Firefly、瑞芯微 Rockchip、选型评估、配套采购 |
A:规格书原文写「NPU 算力 4 TOPS(稀疏 INT8)」,明确标注为稀疏 INT8 口径。这与 RK3576 官方标注的 6 TOPS(INT8)统计口径不同,不能直接相减或当作性能倍数。跨芯片比较前应先对齐稀疏/稠密、量化位宽与测试模型,详见站内《RK3572 / RK3576 / RK3399 对比选型》一文。
A:规格书列举的是「Transformer 架构下超大规模参数模型的私有化部署,如 Gemma 系列、ChatGLM 系列、Qwen 系列、Phi 系列等大语言模型」,属于能力描述与示例清单,并未给出具体参数量、量化方式、上下文长度或实测 TPS。实际可跑模型需按内存容量、量化产物与 RKNN 支持情况逐项验证。
A:W4A16 指权重 4bit、激活 16bit 的量化组合,非对称 MAC 是 NPU 支持的一类乘加运算方式。规格书把它列为 NPU 的支持能力,未给出精度损失或吞吐数据。这类能力通常用于在有限内存下承载更大模型,工程上需结合模型精度评估。
A:规格书列出 CNN、RNN、LSTM 等传统网络架构,支持 RKNN 模型导入导出,并支持多种深度学习框架:TensorFlow、TensorFlow Lite、PyTorch、Caffe、ONNX、MXNet;同时明确「支持自定义算子开发、Docker 容器化管理技术」。
A:规格书只列出单路能力上限与格式清单(H.265/HEVC、VP9、AVS2、AV1;H.264 为 4K@60fps),没有给出多路并发路数。不推断并发能力;多路项目需按码率、内存带宽与业务负载做压测。
A:规格书写「内置 1200 万像素 ISP」,接口侧给出 2 × MIPI CSI DPHY,产品特点写「支持 2 路摄像头输入」与「4K@60fps + 2K@60fps 双屏异显」。原文未标注 12MP 与双路的逐映射关系,不做推定,请以原厂 ISP 数据手册核对。
A:规格书文字为「HD2.1,最高 4K@60Hz」,板卡实物丝印为 HDMI。按规格书照录并标注差异;接口协议版本、HDCP 与线材兼容性属于集成前必须向原厂确认的项,不建议按命名自行推断。
深圳市爱派派智能科技有限公司(爱派派智能)
地址:深圳市坪山区创新广场C栋1805
电话:18681465731
联系人:李先生
官网:https://ai-paipai.com
说明:参数取自《R3572A_Specification_CN》规格书,对比篇另引瑞芯微官网公开资料;Firefly 与瑞芯微为原厂,爱派派智能提供选型评估、配套采购与方案对接支持,未宣称独家代理,报价与交期以项目确认为准。